
目录 (11)
【操作系统】文件系统
UNIX 文件系统支持 File 和 Directory 两种对象。不过 Directory 其实是 File 的一种特殊形式,所以可以把文件系统看作是用来表示 File 的概念。
1. Blocks and Fragments
大多数文件系统都由 data block(数据块)填满,用户的文件就存放在这些块中。下面就来看看这些数据块是如何存储在磁盘上的吧!
磁盘(辅助存储设备)的扇区大小通常是 512 bytes。(现在大多是 4kb 了!!)所以 data block 的大小比 512bytes(4 kb)大一些,看起来速度上会更好,但实际上如果存在大量的小文件,内部碎片就可能变得很严重。因此早期的做法是:文件的所有块都使用较大的块大小(ex. 8kb),只有最后一块使用 n 个小片段(1kb)来收尾。(ex. 26kb 文件 => 8+8+8+1+1)
这种块和片段的大小可以在创建文件系统时决定,最好根据自己使用文件系统的目的来合理设置。例如,可以按下面的方式来考虑设置值。
如果预计会产生大量小文件,最好把片段大小设小;
如果经常传输大文件,最好把块大小设大。
类别 | 块 (Block) | 片段 (Fragment) |
|---|---|---|
含义 | 文件系统的基本分配单位 | 把块进一步细分得到的子单位 |
大小 | 通常为 4KB、8KB 等 | 比块小(例:512B、1KB 等) |
目的 | 用于快速访问磁盘及处理大文件 | 为了在存储小文件时减少空间浪费 |
用途 | 文件的大部分以块为单位存储 | 仅用于文件的最后一部分 |
Why | 为了提升磁盘性能而把块设大 | 因为块太大会让小文件浪费空间而产生 |
不过实际上,[块大小:片段大小] 的比例最大只能是 [8:1],而且最小块大小必须是 4kb。所以一般的设置如下。
以小文件为主的设置:4kb 块 / 512byte 片段组合
以大文件为主的设置:8kb 块 / 1kb 片段组合
现在我好像隐约明白了,为什么建 DB 表的时候,字段的数据大小大多使用 2 的倍数。不管是内存、磁盘、缓冲区还是页,全都使用 2 的倍数,这样处理起来刚好对得上,程序也会更高效。做网站的时候,如果把图片这类文件的大小也限制为 4kb 的倍数,会不会高效很多呢?
2. Inode
文件用 inode 来表示。inode 是存储某个文件相关信息的记录。inode 指的是 "index node",最初写作 i-node,后来渐渐写成了 inode。

inode 包含文件的用户及组标识符、最后修改/访问时间、硬链接数量、文件类型(普通文件、目录、符号链接、字符设备等)等信息。另外,inode 拥有 15 个指针,指向存储文件数据的磁盘块。其中 12 个指针指向 direct blocks(直接块),这些指针保存着存储数据的块的地址。这意味着小文件(12 个块以内)可以直接引用数据。因为 inode 的副本会保留在主内存中,如果块大小为 4kb,那么通过 inode 最多可以直接访问 48kb 的数据。如果文件比较大,就还必须借助其余 3 个指针所指向的 indirect blocks(间接块)来访问。剩下的这 3 个指针分别引用一级间接块(single indirect)、二级间接块(Double Indirect Block)和三级间接块(Triple Indirect Block)。以一级间接块为例,假设一个块分配为 4kb、地址为 4 字节,那么一级间接块中可以存储 1024 个数据块的地址,再通过这些地址去访问数据块。
直接块:4kb * 12 pointer = 可访问 48kb
一级间接块:(4kb / 块指针大小 4byte) * 4kb = 可访问 4096kb
二级间接块:(4096 kb/ 块指针大小 4byte) * 4kb = 可访问 4194304kb
三级间接块:(4194304kb/ 块指针大小 4byte) * 4kb = 可访问 4294967296kb(效率太低,只在理论上存在)
据说过去的 4.2BSD 文件系统只用到了二级间接块,所以通过 inode 可以访问 4194304kb => 比 232 字节稍大一点的空间;而 232 这个值之所以重要,是因为主内存中文件结构体的文件偏移量是以 32 位字(word)来存储的。又因为文件指针是有符号整数,并且必须能在文件内前后移动查找,所以实际的最大文件大小是 232-1 字节(4GB)。
如今都使用 64 位操作系统,所以情况如下。其实最新的操作系统虽然还在使用 inode 的概念,但已经不再使用间接块结构了。
项目 | 32 位系统 | 64 位系统(实际上不使用间接块结构) |
|---|---|---|
最大文件大小 | 约 2~4 GB | 理论上约 8 EB |
文件偏移量大小 | 32 位 (signed) | 64 位 (signed) |
下面是较新的操作系统中使用的 Extent 数据结构。

Extent 是一种存储连续块的 offset 和数量的方式。由于以连续块进行分配,碎片化更少,而且只需要较少数量的 Extent(相比数据块方式)就能处理 inode 的数据访问,因此更加高效。
3. Directory
普通文件和目录在实现层面上是没有区别的。这是什么意思呢?就是说目录的内容同样存储在数据块中,并且用 inode 来表示。只不过 inode 的 type 与普通文件不同,并且具有特定的结构。
3.1 文件名与 inode
用户通过 path name 来区分文件,而文件系统则通过 inode 来定义文件。所以 OS 必须能把 path name 和 inode 关联起来,承担这个角色的就是 directory。文件名转换为 inode 的过程如下。
首先确定起始目录(starting directory)。
如果路径名以 / 开头,就从根目录开始。
如果不以斜杠(/)开头,就以当前进程的当前目录作为起点。
检查起始目录的文件类型和访问权限,如果有问题就返回错误。
路径的下一个组成部分(直到下一个 / 或字符串末尾)就是文件名。
在起始目录中查找这个名字,如果找不到就返回错误。
如果路径中还有其他组成部分,那么当前 inode 必须是目录,
如果不是目录或访问被拒绝,就返回错误。
然后,再按照上面的方式重新搜索那个目录。
重复这个过程直到路径名的末尾,就能找到想要的 inode。之所以要这样一步步进行,是因为遇到挂载点或符号链接时,需要切换到其他的目录结构。
如果通过 open() 系统调用找到了 inode,就会分配该 inode 所指向的文件结构体(file structure),并由 file descriptor 引用这个文件结构。另外,由于 directory name -> inode 的转换操作非常频繁,通常会建立 directory name cache 来加以利用。
3.2 挂载点、硬链接、符号链接、Windows 快捷方式
这里就用一张对比汇总表来总结上面这 4 种。使用硬链接、符号链接的主要原因是:不浪费存储空间,只使用路径值,从而让其他目录也能使用同一个文件。
项目 | 挂载点 (Mount Point) | 硬链接 (Hard Link) | 符号链接 (Symbolic Link) | Windows 快捷方式 (Shortcut) |
|---|---|---|---|---|
定义 | 用于连接其他文件系统的路径 | 基于 inode 共享同一个文件 | 以字符串形式引用其他文件路径 | 包含文件信息的GUI 用引用文件 |
工作方式 | 把其他文件系统连接到目录上(USB) | 一个 inode 上连接多个目录项 | 沿着路径字符串重新查找 | 把文件路径和运行选项等保存在 .lnk 文件中 |
引用对象 | 磁盘、分区、目录 | 同一个文件(相同 inode) | 文件或目录(基于路径) | 文件或目录(基于路径) |
文件系统 | 可以是不同的文件系统 | 只能在同一个文件系统内 | 可以跨越文件系统边界(云) | 一般在 Windows NTFS 上使用 |
删除目标时 | 卸载后无法访问 | 只要还剩一个链接,文件就会保留(inode 链接数) | 目标被删除后变成断开的链接 | 删除目标时只会警告,运行会失败 |
目录链接 | 只能是目录 | 通常不能用于目录(., .. 问题) | 目录也可以 | 目录也可以 |
是否可能循环 | 不可能 | 不可能 | 有(限制 8 层) | 无 |
命令示例 | mount /dev/sdb1 /mnt/usb | ln file.txt file2.txt | ln -s file.txt link.txt | 鼠标右键 → "创建快捷方式" |
4. File Descriptor 与 inode 映射

inode 映射是这样开始的:引用已打开文件的 System Call 会把 file descriptor 作为参数传入,以此指定对应的文件。
内核利用 File Descriptor 对当前进程的 tables of open files(打开文件表)进行索引。
表中的每一项都持有一个指向 file structure 的指针。
这个 file-structure 又持有一个指向 inode 的指针。
这个 inode 是磁盘上 inode 在内存中的副本,此外还保存着诸如有多少个进程在引用它之类的值。如果各个进程分别 open 同一个 file,它们的 offset(读写位置)是不共享的;但如果是 fork 出来使用的,offset 就会共享。(需要加锁)
5. 磁盘结构
用户看到的文件系统是构建在磁盘这类大容量存储设备之上的。用户通常只感知到一个文件系统,但这一个逻辑文件系统实际上可能由多个真实存在的物理文件系统组成。另外,人们通常希望把一个大的磁盘设备分区成多个逻辑设备,而每个逻辑设备定义一个物理文件系统。

从上图可以看出,目录结构被划分到各个文件系统中,每个文件系统映射到一个逻辑设备,而这些逻辑设备又由物理设备的分区构成。
分区的优点
用途分离:每个分区可以用于不同的用途。
交换空间:部分分区可以用作虚拟内存的交换空间。
提高可靠性:即使发生软件损坏,也只会损坏对应的文件系统,从而减少对整个系统的影响。
提高效率:可以为每个分区调整块/片段大小,以优化性能。
防止空间滥用:防止某一个程序占满所有空间。因为文件不会跨越文件系统存储。
提高备份性能:因为以分区为单位进行备份,分区越小,就能越快地在备份磁带中检索到想要的文件,整体恢复也更快。
5.1 挂载处理(怎么查看其他设备上的文件??)
每个系统都必定有一个根文件系统(root file system),其余的文件系统则通过挂载(mount)整合到目录结构中。
inode 结构体中有一个位,用来表示该 inode 上是否挂载了其他文件系统。假设某个路径引用了已挂载的文件系统,那么就会搜索挂载表(mount table),找到被挂载设备的设备号,再用这个设备号找到已挂载文件系统的 root directory 的 inode,并使用这个 inode。
就像上面这样,把已挂载设备的 root directory 的 inode 连接起来。(正因为有这种连接,也意味着必须存在一个根文件系统。)
6. 前端(我最喜欢的)PNPM 与 Symbolic Link、Hard Link、Inode 讲解
我做前端时最早用的包管理器是 NPM。它慢得要命,而且在 Hoisting 的过程中还会产生幽灵依赖。后来我了解到了 yarn berry 和 pnpm,其中 pnpm 利用 Symbolic Link 和 Hard Link,可以在不浪费存储空间的情况下使用,我觉得它实在太棒了,于是就开始用 pnpm 了。
pnpm 的存储结构如下。(我自己画的,可能有错..?)
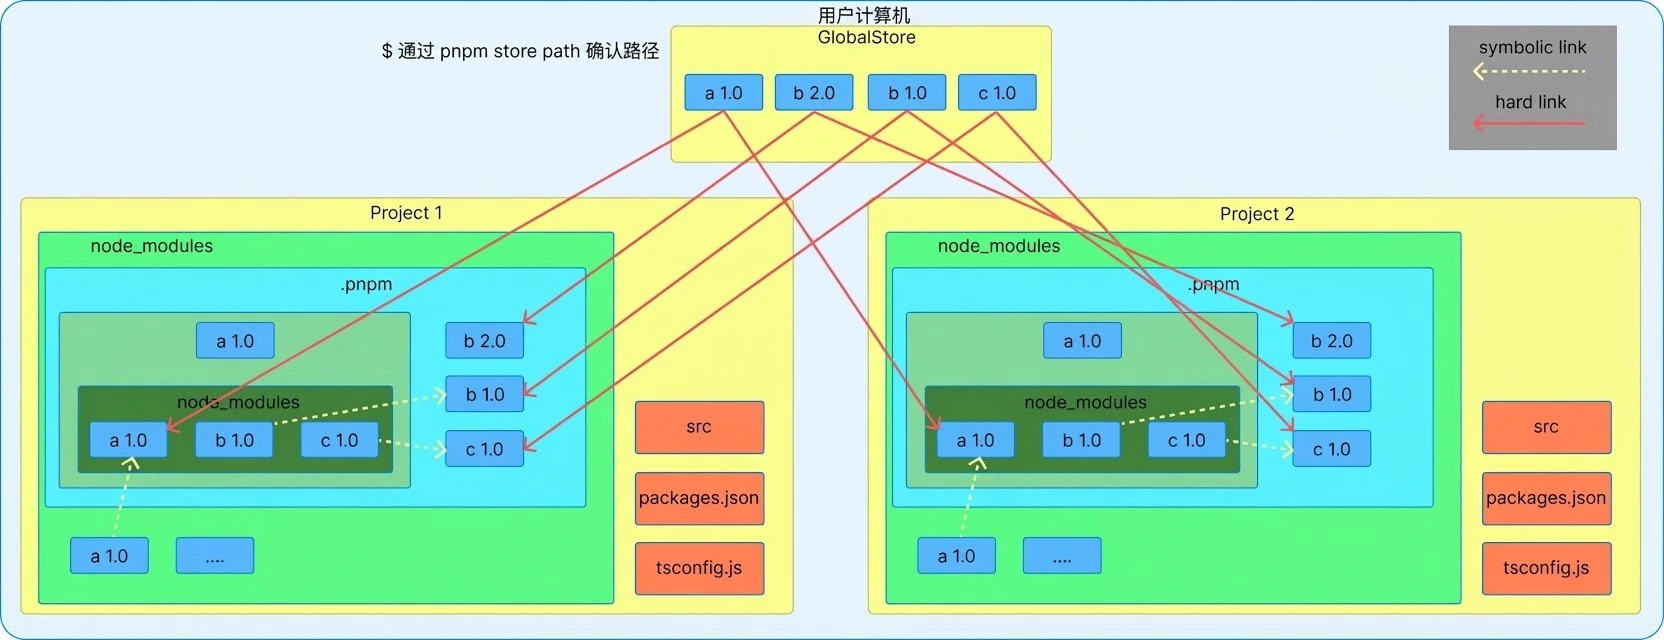
除了部分使用 native 资源的包(有 OS 依赖的包)之外,其他的包都会先通过 pnpm store 的 hard link 创建副本,然后不经过 hoisting,按照原有结构把依赖包以 symbolic link 的方式复制过来。因为只复制路径来使用,所以可以节省磁盘空间。
下面是从 pnpm 官网拿来的图片。

虽然每个项目都有各自的文件,但实际上它们都是同一份文件。

用 ls -li 命令查看时,也可以确认 LICENSE 文件存在 51 个 Hard Link。

另外,从上图还能看到 symbolic 链接具体连接到了哪里。
两者的区别在于:hard link 是指向同一个 inode 的链接有多个,而 symbolic 链接则是让另一个 inode 的文件能够访问原始文件。
硬链接 (Hard Link)
硬链接不会创建新的索引节点(inode)。原始文件和硬链接指向同一个 inode。
硬链接不支持目录,只在文件层面起作用。另外,也不能跨磁盘分区使用。
在原始文件和所有硬链接都被删除之前,文件不会被真正删除。
符号链接 (Symbolic Link)
符号链接保存原始文件的路径,并通过它指向原始文件。和快捷方式(Shortcut)类似,但并不相同。(写代码时没法保持路径!!!路径问题解决不了)
符号链接同时支持目录和文件,它和原始文件是不同的文件。也就是说,inode 值不同,文件类型也不同。因此可以跨分区访问。(类似在 GIT 中创建符号链接文件夹的概念、连接云端的概念)
即使原始文件被删除,符号链接仍然存在,但无法再通过这个链接访问原始文件。
那 pnpm 就是无敌的吗??答案是否定的!!因为实际上有不少库存在无法使用 pnpm 的情况。拿我来说,React-Native 之前一直不支持 pnpm,直到最近才开始支持,我才用上了。使用前请务必先确认是否支持。
结语
今天我们了解了文件系统。其实各个 OS 都已经发展了很多,所以没办法涵盖所有内容。不过在查资料的过程中我发现,它们的方式大同小异,真正需要的时候再去看就好。它在日常生活中也很有用。当需要同时打开多个同一个程序时,不用直接复制粘贴,而是用符号链接、硬链接来复制,就能打开多个。(如果是 10GB 的游戏,不用复制 10GB,只复制路径,简直血赚)
希望我的文章能给大家带来很多帮助!!