
目次 (11)
[オペレーティングシステム] ファイルシステム
UNIXのファイルシステムはFileとDirectoryオブジェクトをサポートしています。ただ、Directoryは実はFileの特別な形式なので、ファイルシステムはFileを表現するための概念だと考えればよいです。
1. Blocks and Fragments
ほとんどのファイルシステムはdata blockで埋められており、このブロックにはユーザーのファイルが格納されています。では、これらのデータブロックがどのようにディスクに保存されるのか見ていきましょう!
ディスク(補助記憶装置)のセクターサイズは通常512 bytesです。(最近はほとんどが4kbです!!)そのため、data blockのサイズはこの512bytes(4 kb)より大きいほうが速度的には良さそうに見えますが、実際には非常に多くの小さなファイルが存在すると、内部断片化がひどくなる可能性があります。そこで初期には、ファイルのすべてのブロックに大きなブロックサイズ(ex. 8kb)を使い、最後のブロックだけ小さなフラグメント(1kb)*n個を使ってファイルを締めくくっていました。(ex. 26kbのファイル => 8+8+8+1+1)
こうしたブロックとフラグメントのサイズはファイルシステムの作成時に決めることができ、自分のファイルシステムの使用目的に合わせて適切に設定するとよいです。例えば、以下のような考え方で設定値を検討すればよいです。
小さなファイルが多く作成されると予想される場合は、フラグメントサイズを小さく設定するのがよく、
大きなファイルを頻繁に転送する場合は、ブロックサイズを大きく設定するのがよいです。
区分 | ブロック (Block) | フラグメント (Fragment) |
|---|---|---|
意味 | ファイルシステムの基本的な割り当て単位 | ブロックをさらに細かく分けたサブ単位 |
サイズ | 通常4KB、8KBなど | ブロックより小さい(例: 512B、1KBなど) |
目的 | 高速なディスクアクセスと大きなファイルの処理のため | 小さなファイルを保存する際の領域の無駄を減らすため |
用途 | ファイルの大部分がブロック単位で保存される | ファイルの最後の一部にのみ使われる |
Why | ディスク性能を向上させるためにブロックを大きく | ブロックが大きすぎると小さなファイルで領域が無駄になるため生まれた |
ただ実際には、[ブロックサイズ:フラグメントサイズ]の比率は最大[8:1]でなければならず、最小ブロックサイズは4kbでなければなりません。そのため、一般的な設定は以下のとおりです。
小さなファイル中心の設定: 4kbブロック / 512byteフラグメントの組み合わせ
大きなファイル中心の設定 : 8kbブロック / 1kbフラグメントの組み合わせ
これで、DBテーブルを作るときにフィールドのデータサイズになぜ2の倍数がよく使われるのか、なんとなく分かった気がします。メモリでも、ディスクでも、バッファでも、ページでも、すべて2の倍数を使うので、ぴったり合わせて処理すれば効率的なプログラミングになりそうです。Webサイトを作るときも、画像などのファイルサイズを4kbの倍数に制限すれば、ずっと効率的になるのではないでしょうか?
2. Inode
ファイルはinodeで表現されます。inodeは、あるファイルに関する情報を保存する記録です。inodeは"index node"のことで、もともとはi-nodeと表記されていましたが、次第にinodeと表記されるようになりました。

inodeには、ファイルのユーザーおよびグループ識別子、最終ファイル更新/アクセス時刻、ハードリンク数、ファイルの種類(通常ファイル、ディレクトリ、シンボリックリンク、キャラクタデバイスなど)の情報が含まれます。そしてinodeは、ファイルデータが保存されたディスクブロックを指す15個のポインタを持っています。このうち12個のポインタはdirect blocksを指し、これらのポインタにはデータが保存されたブロックのアドレスが入っています。これが意味するのは、小さなファイル(12ブロック以下)はデータを直接参照できるということです。なぜなら、inodeのコピーがメインメモリに保持されているからで、ブロックサイズが4kbであれば、inodeを通じて最大48kbまでのデータに直接アクセスできます。ファイルサイズが大きい場合は、残り3つのポインタが指すindirect blocksも使ってアクセスする必要があります。この残り3つのポインタは、それぞれ単一間接ブロック(single indirect)、二重間接ブロック(Double Indirect Block)、三重間接ブロック(Triple Indirect Block)を参照します。単一間接ブロックの場合、1ブロックが4kbで割り当てられ、アドレスが4バイトだと仮定すると、単一間接ブロックには1024個のデータブロックのアドレスが格納され、そのアドレスを通じてデータブロックにアクセスすることになります。
直接ブロック : 4kb * 12 pointer = 48kbにアクセス可能
単一間接ブロック : (4kb / ブロックポインタサイズ 4byte) * 4kb = 4096kbにアクセス可能
二重間接ブロック : (4096 kb/ ブロックポインタサイズ 4byte) * 4kb = 4194304kbにアクセス可能
三重間接ブロック : (4194304kb/ ブロックポインタサイズ 4byte) * 4kb = 4294967296kbにアクセス可能(非効率すぎるため理論上のみ存在)
このとき、昔の4.2BSDファイルシステムは二重間接ブロックまでしか使わなかったそうで、そのためinodeで4194304kb => 232バイトより少し大きい範囲までアクセスでき、232 という値は、メインメモリ上のファイル構造体のファイルオフセットが32ビットワードで保存されるため重要なのだそうです。ファイルポインタは符号付き整数であり、ファイル内で前後に探索できる必要があるため、実際の最大ファイルサイズは232-1バイト(4GB)だそうです。
今日では64ビットOSを使うので以下のようになりますが、実は最新のOSはinodeの概念は使っていても、間接ブロック構造は使っていません。
項目 | 32ビットシステム | 64ビットシステム(実質的に間接ブロック構造は使わない) |
|---|---|---|
最大ファイルサイズ | 約2〜4 GB | 理論上約8 EB |
ファイルオフセットサイズ | 32ビット (signed) | 64ビット (signed) |
以下は、より新しいOSで使われているExtentデータ構造です。

Extentは、連続したブロックのoffsetと個数を保存する方式です。連続したブロックとして割り当てるので断片化が少なく、(データブロック方式より)少ない数のExtentでinodeデータへのアクセスを処理できるため、より効率的です。
3. Directory
通常ファイルとディレクトリは、実装レベルでは区別されません。どういうことかというと、ディレクトリの内容もデータブロックに保存され、inodeで表現されるという意味です。ただし、inodeのtypeが通常ファイルとは異なり、独自の構造を持ちます。
3.1 ファイル名とinode
ユーザーはファイルをpath nameで区別しますが、ファイルシステムはinodeでファイルを定義します。そのため、OSはpath nameとinodeを結び付けられなければならず、directoryがその役割を担います。そして、ファイル名がinodeに変換される過程は次のとおりです。
まず開始ディレクトリ(starting directory)を決定します。
パス名が/で始まる場合は、ルートディレクトリから開始します。
スラッシュ(/)で始まらない場合は、現在のプロセスのカレントディレクトリを開始点とします。
開始ディレクトリのファイルタイプとアクセス権限を確認し、問題があればエラーを返します。
パスの次の要素(次の/まで、または文字列の終わりまで)がファイル名です。
開始ディレクトリでこの名前を探し、見つからなければエラーを返します。
パスにさらに別の要素がある場合、現在のinodeはディレクトリでなければならず、
ディレクトリでない場合やアクセスが拒否された場合はエラーを返します。
その後、そのディレクトリを上と同じ方法で再び検索します。
この過程をパス名の最後まで繰り返して目的のinodeを見つけます。このように段階的に進める理由は、マウントポイントやシンボリックリンクに出会ったときに、別のディレクトリ構造へ切り替える処理が必要になるからです。
inodeがopen()システムコールで見つかると、そのinodeが指すファイル構造体(file structure)が割り当てられ、file descriptorがそのファイル構造体を参照して示します。また、通常はdirectory name -> inodeへの変換作業が多いため、directory name cacheを作って活用します。
3.2 マウントポイント、ハードリンク、シンボリックリンク、Windowsショートカット
ここでは、上の4つについて比較要約表でまとめたいと思います。ハードリンクやシンボリックリンクを使う主な理由は、容量を無駄にせず、パスの値だけを使えるようにすることで、別のディレクトリでも同じファイルを使えるようにするためです。
項目 | マウントポイント (Mount Point) | ハードリンク (Hard Link) | シンボリックリンク (Symbolic Link) | Windowsショートカット (Shortcut) |
|---|---|---|---|---|
定義 | 別のファイルシステムを接続するパス | 同じファイルをinode基準で共有 | 別のファイルパスを文字列で参照 | ファイル情報を持つGUI用の参照ファイル |
動作方式 | ディレクトリに別のファイルシステムを接続(USB) | 1つのinodeに複数のディレクトリエントリが結び付く | パス文字列をたどって再探索 | ファイルパスや実行オプションなどを.lnkファイルに保存 |
参照対象 | ディスク、パーティション、ディレクトリ | 同一のファイル(同じinode) | ファイルまたはディレクトリ(パスベース) | ファイルまたはディレクトリ(パスベース) |
ファイルシステム | 異なるファイルシステムも可能 | 同一ファイルシステム内でのみ可能 | ファイルシステムの境界を越えられる(クラウド) | 一般的にWindowsのNTFS上で使用 |
対象削除時 | アンマウントされるとアクセス不可 | リンクが1つでも残っていればファイルは維持される(inodeのリンク数) | 対象が削除されるとリンク切れになる | 対象削除時は警告のみで、実行は失敗 |
ディレクトリリンク | ディレクトリのみ可能 | 通常はディレクトリに使えない(., .. の問題) | ディレクトリも可能 | ディレクトリも可能 |
ループの可能性 | 不可能 | 不可能 | あり(8段階の制限) | なし |
コマンド例 | mount /dev/sdb1 /mnt/usb | ln file.txt file2.txt | ln -s file.txt link.txt | マウスで右クリック → 「ショートカットの作成」 |
4. File Descriptorとinodeのマッピング

inodeのマッピングは、開いているファイルを参照するSystem Callが、file descriptorを引数として渡して対象のファイルを指定するところから始まります。
カーネルはFile Descriptorを使って、現在開いているプロセスのtables of open filesをインデックス参照します。
テーブルの各項目は、file structureを指すポインタを持ちます。
このfile structureは、さらにinodeを指すポインタを持ちます。
このinodeはディスク上のもののメモリ内コピーで、さらに何個のプロセスが参照しているかといった値を持ちます。個々のプロセスがそれぞれ同じfileをopenした場合、そのoffset(読み書きする位置)は共有されませんが、forkして使う場合は共有されます。(ロックが必要)
5. ディスク構造
ユーザーが目にするファイルシステムは、ディスクのような大容量ストレージ装置の上に構成されています。ユーザーは通常1つのファイルシステムしか意識しませんが、その1つの論理的なファイルシステムは、実際には複数の実在する物理的なファイルシステムで構成されている場合があります。そして通常は、1つの大きなディスク装置を複数の論理装置にパーティショニングすることが望まれ、各論理装置は1つの物理的なファイルシステムを定義します。

上の図を見ると、ディレクトリ構造がファイルシステムに分かれ、各ファイルシステムが論理装置にマッピングされ、これらの論理装置が物理装置のパーティションで構成される構造が示されています。
パーティショニングのメリット
用途の分離: 各パーティションを異なる用途に使えます。
スワップ領域: 一部のパーティションは仮想メモリのスワップ領域として使えます。
信頼性の向上: ソフトウェアの損傷があってもそのファイルシステムだけが損傷するため、システム全体への被害を減らせます。
効率の向上: パーティションごとにブロック/フラグメントのサイズを調整して、性能を最適化できます。
領域の乱用防止: 1つのプログラムがすべての領域を占有しないようにします。ファイルはファイルシステムをまたいで保存されないためです。
バックアップ性能の向上: パーティション単位でバックアップされるため、小さなパーティションほどバックアップテープから目的のファイルをより速く検索でき、全体の復元もより速くなります。
5.1 マウント処理(他のデバイスのファイルはどう見る??)
すべてのシステムには必ず1つのルートファイルシステム(root file system)があり、残りのファイルシステムはマウント(mount)されてディレクトリ構造に統合されます。
inode構造体の中には、そのinodeに別のファイルシステムがマウントされているかどうかを示すビットがあります。あるパスがマウントされたファイルシステムを参照していると仮定すると、マウントテーブル(mount table)を検索してマウントされたデバイスのデバイス番号を見つけ、この番号でマウントされたファイルシステムのroot directoryのinodeを見つけて、そのinodeを使います。
このような方法で、マウントされたデバイスのroot directoryのinodeを接続します。(この接続のために、必ずルートファイルシステムがなければならないという意味でもあります。)
6. フロントエンド(私の好きな)PNPMとSymbolic Link、Hard Link、Inodeの解説
私がフロントエンドを始めて最初に使ったパッケージマネージャーはNPMでした。とにかく遅すぎるうえに、Hoistingの過程で幽霊依存が生じることもあります。そんな中で知ったのがyarn berryとpnpmで、その中でもSymbolic LinkとHard Linkを使って容量を無駄にせずに使えるpnpmがとても良さそうに見えたので、pnpmを使うようになりました。
pnpmは以下のようなストア構造を持っています。(自分で描いたので間違っているかも…?)
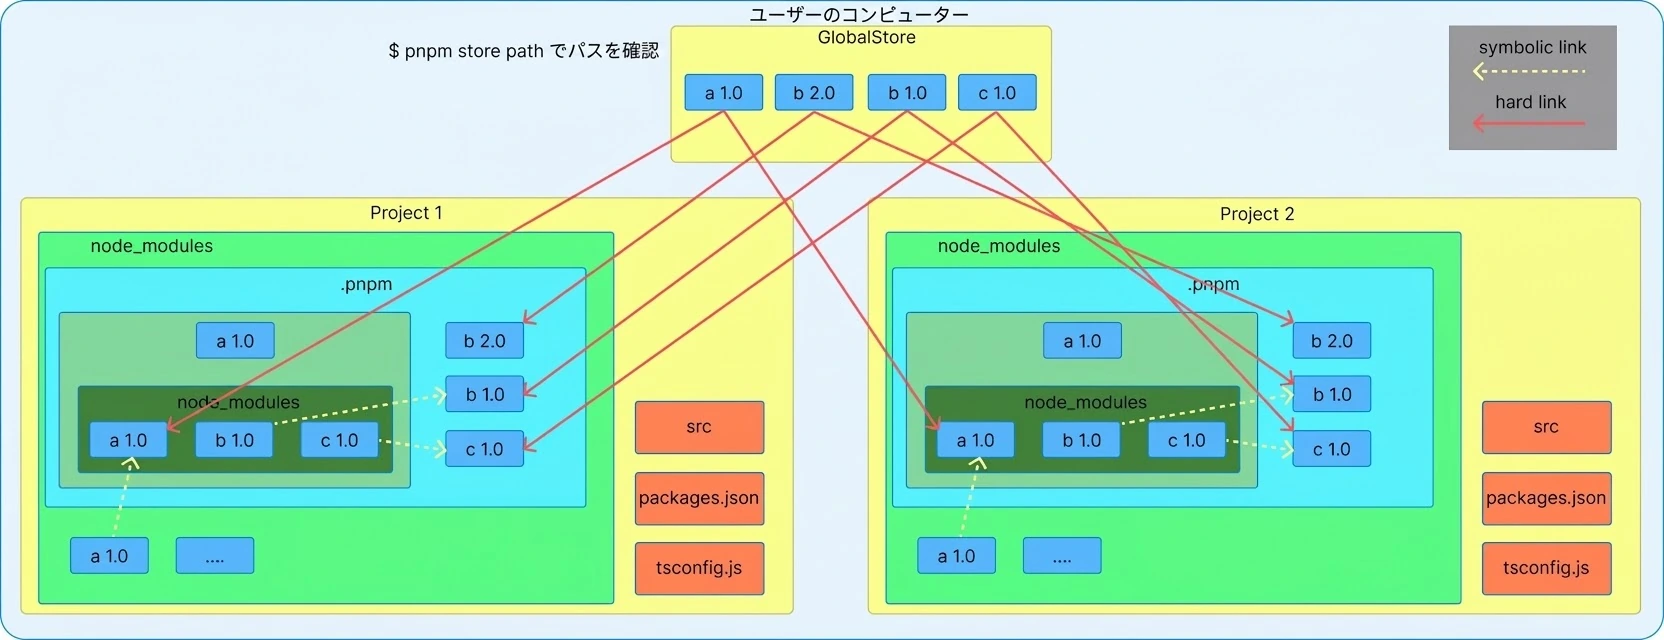
一部のnativeリソースを使うパッケージ(OS依存のあるパッケージ)を除き、すべてpnpm storeのhard linkでコピーを作った後、hoistingなしで構造そのままに依存パッケージをsymbolic linkでコピーします。つまり、パスだけをコピーして使うので、ディスク容量を節約できます。
以下はpnpmのサイトから持ってきた画像です。

プロジェクトごとにファイルを持っていますが、実際には1つのファイルです。

ls -li コマンドで見ても、LICENSEファイルには51個のHard Linkが存在することが確認できます。

そして上の画像では、symbolicリンクがどこにつながっているかまで確認できます。
両者の違いは、hard linkは同じinodeを持つリンクが複数存在するものであるのに対し、symbolicリンクは別のinodeのファイルが元のファイルにアクセスできるようにするものだという点です。
ハードリンク (Hard Link)
ハードリンクは新しいインデックスノード(inode)を作成しません。元のファイルとハードリンクは同じinodeを指します。
ハードリンクはディレクトリをサポートせず、ファイルレベルでのみ動作します。また、ディスクパーティション間では使えません。
元のファイルとすべてのハードリンクが削除されるまで、ファイルは実際には削除されません。
シンボリックリンク (Symbolic Link)
シンボリックリンクは元のファイルのパスを保存し、それを通じて元のファイルを指します。ショートカット(Shortcut)と似ていますが、別物です。(コーディング中はパスを維持できない!!!パスの問題が解決できない)
シンボリックリンクはディレクトリとファイルの両方をサポートし、元のファイルとは別のファイルです。つまり、inodeの値が異なり、ファイルの種類も異なります。そのため、パーティションをまたいでもアクセスできます。(GITでシンボリックリンクのフォルダを作る概念、クラウド接続の概念)
元のファイルが削除された後もシンボリックリンクはそのまま存在しますが、そのリンクを通じて元のファイルにアクセスすることはできません。
では、pnpmは無敵なのか??というと、そうではありません!!なぜなら、実際にはpnpmを使えないライブラリがいくつもあったからです。私の場合はReact-Nativeがpnpmをサポートしていませんでしたが、最近になってようやくサポートされ始めたので、使ってみた経験があります。必ずサポート状況を確認してから使ってください。
まとめ
今日はファイルシステムについて見てきました。実際にはOSごとに大きく発展してきたので、そのすべてを扱うことはできませんでした。しかし、資料を調べる中で、その方式は大同小異だということが分かったので、本当に必要になったときに調べればよいと思います。日常生活でも役立てることができます。シンボリックリンクやハードリンクは、同じプログラムを複数起動する必要があるときに、直接コピー&ペーストするのではなく、シンボリックリンクやハードリンクでコピーすれば複数起動できます。(10GBのゲームなら、10GBをコピーするのではなくパスだけをコピーするので超お得)
以上、私の記事が皆さんのお役に立てば幸いです!!