
目录 (7)
【博客介绍】为增加博客流量而支持 4 种语言 — 路由·翻译·图片·语义搜索及其局限
本文由 AI 70% 人工 30%撰写。
我想让原本只用韩语运营的博客获得更多访问者,于是决定连同英语·日语·中文一起支持 4 种语言。
为了真正带来流量,我不仅把外国访问者自动引导到合适的语言 ,还完成了 文章文本翻译 → 文章图片翻译 → 多语言搜索。
1. 立即为外国访问者展示合适的语言:URL 路由与语言检测
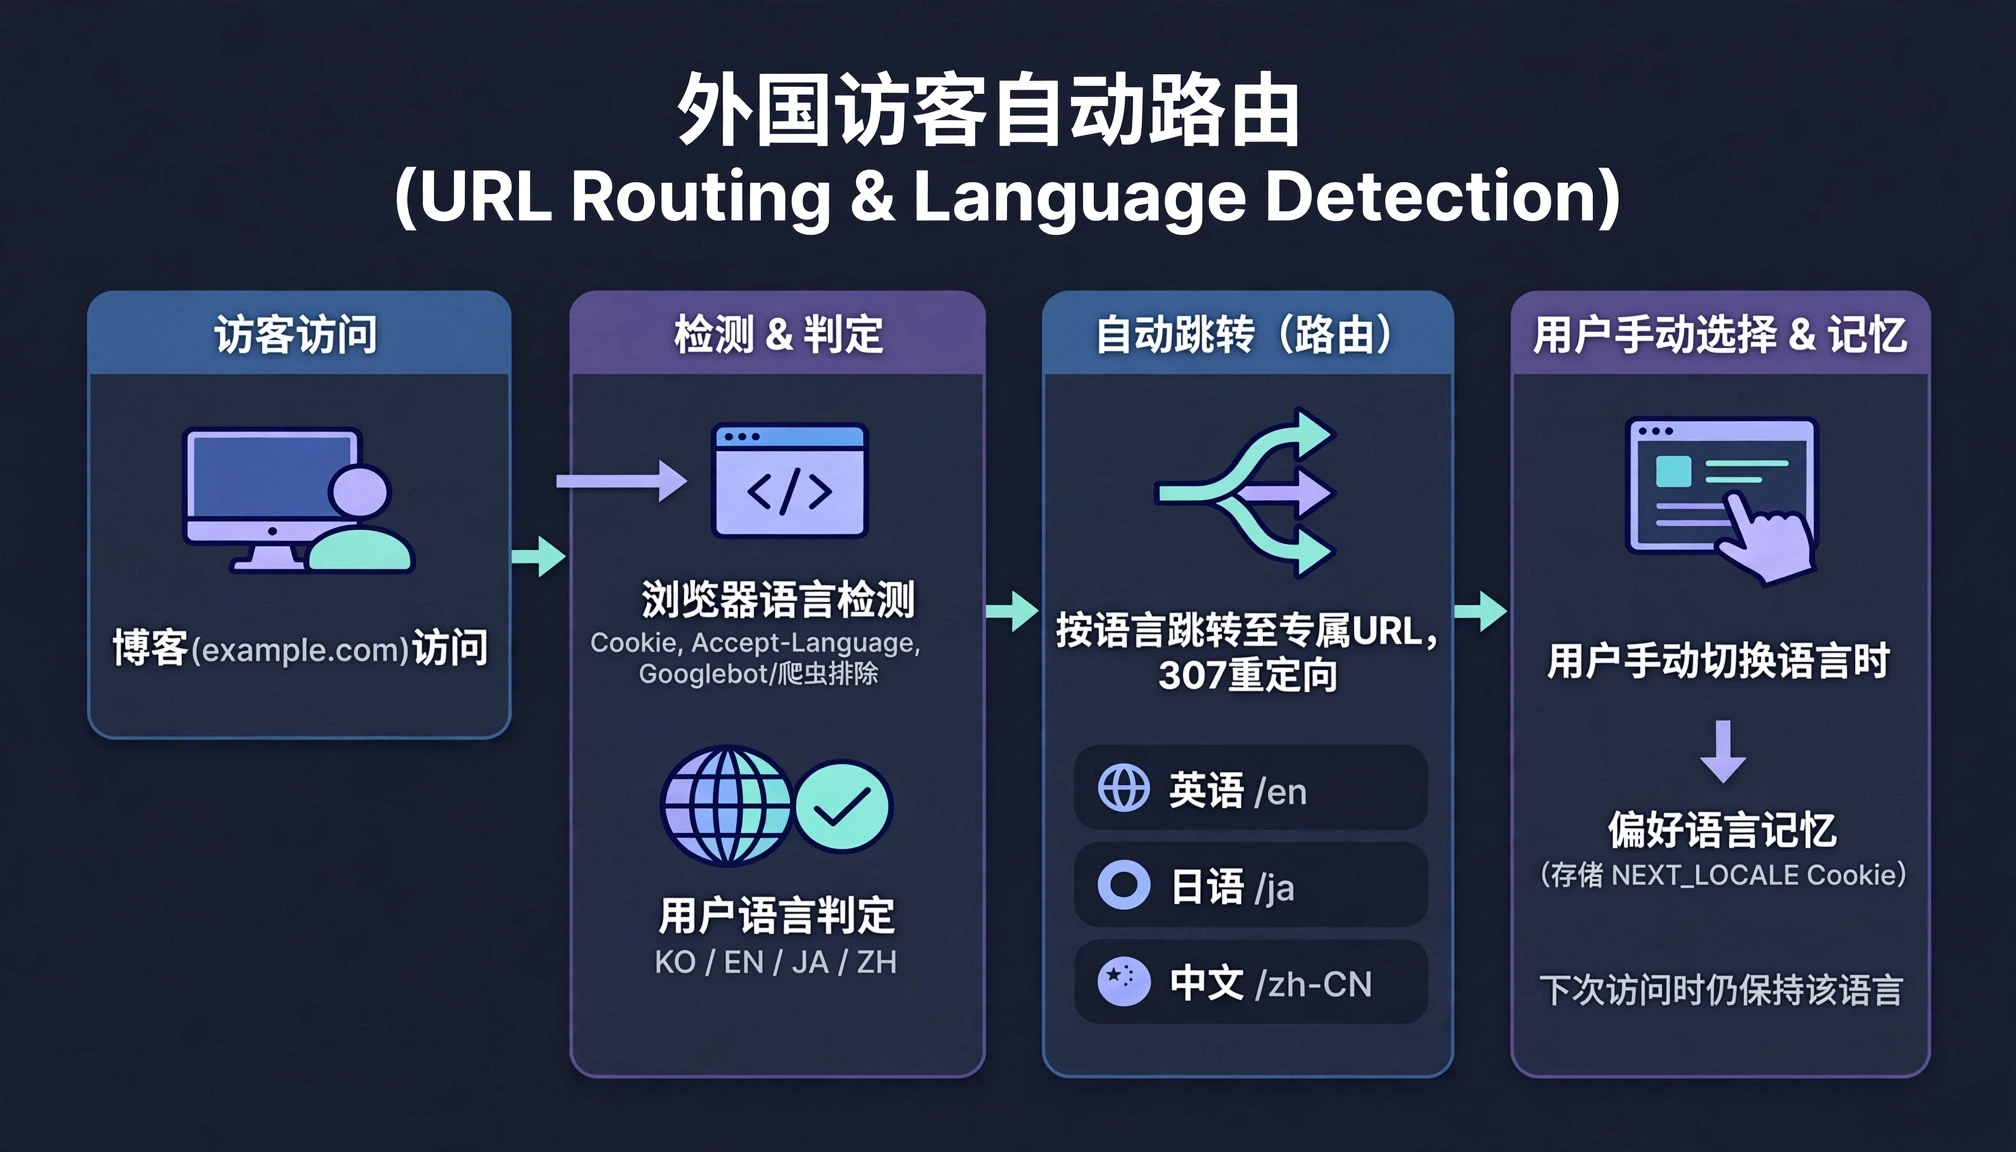
我想,如果对通过搜索或链接从海外进来的访问者直接展示韩语页面,他们很可能马上就会离开。
所以我 用 /en · /ja · /zh-CN 前缀把外语 URL 分开,然后在首次访问时根据访问者的语言直接跳转。(利用 Next.js 的 proxy)
自动跳转到首选语言:访问不带前缀的地址时,按
NEXT_LOCALECookie → 浏览器Accept-Language(按q值排序,繁体中文也归为zh-CN,没有支持的语言时使用en)的顺序判断,并以307跳转到对应语言的地址。记住用户自己选择的语言:通过页头的语言菜单或文章顶部的语言链接切换语言时会写入 Cookie,这样即使日语浏览器用户点击韩语原文,也不会再被送回
/ja。区分搜索机器人:Googlebot 和链接预览机器人不参与重定向,以保护韩语索引。
2. 文章翻译:Google Translate
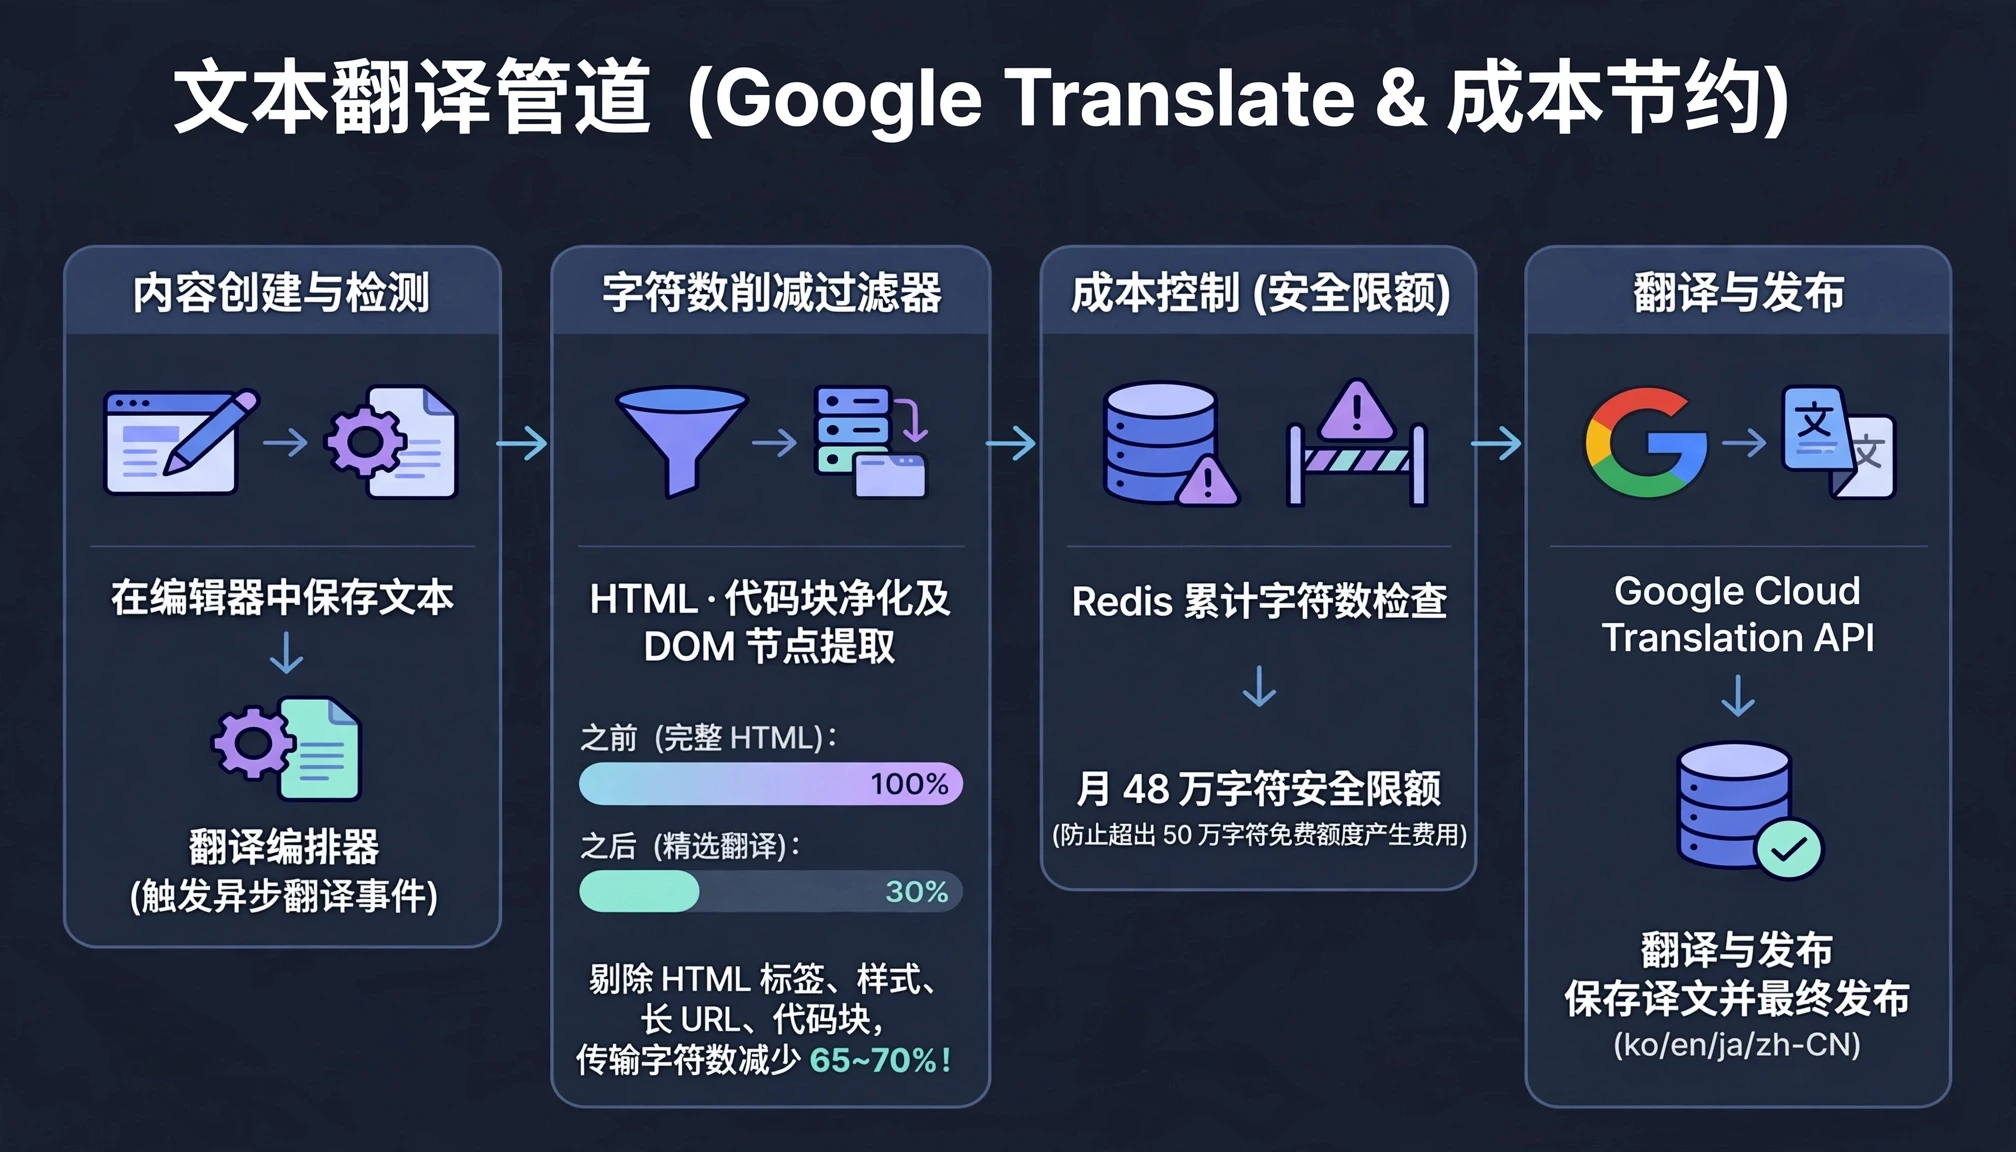
翻译引擎使用的是每月 50 万字符以内免费的 Google Cloud Translation。因为是个人博客,我不想超出免费额度被收费,所以在 Redis 中记录每月累计翻译字符数,只允许执行到 480,000 字符,设置了一条安全线。
由于额度是固定的,减少发送的字符数本身就很重要。我试着把编辑器保存的 HTML 原样发送,发现比起实际正文,HTML 标签·样式·长 URL·语法高亮的代码块占用了大部分字符数。
<table>、style、长长的href属性全部计入字符数Shiki 拆分成
<span style="color:...">的整个代码块都要计费列表预览(
preview)与正文分开重复翻译
结构·属性保存在本地 DOM 中:纯文本块只发送不带标签的纯文本(
TEXT),<a>·<span>的长属性暂时替换为id="a0",之后再还原保护行内代码(
<code>):用<span class="notranslate">__CT0__</span>包裹,防止误译和浪费字符数代码块(
<pre>)只挑出韩语:纯英文代码以字符数0跳过,只从夹杂韩语的行中提取注释·字符串字面量进行翻译在本地生成
preview:从翻译后的正文 HTML 中去掉标签生成
用这种方式,以实际文章为基准,发送字符数减少了约 65~70%。 系列标题·说明(series_translation)也走同一条流水线。
其实在做这个功能时,我在想:用 JSON 方式整理文章结构再渲染,对翻译和其他后处理会不会更好。因为用 JSON 就不需要硬把各种标签剥掉再处理,能更干净地提取翻译所需的字符串。
3. 图片·缩略图翻译:利用图像生成 LLM
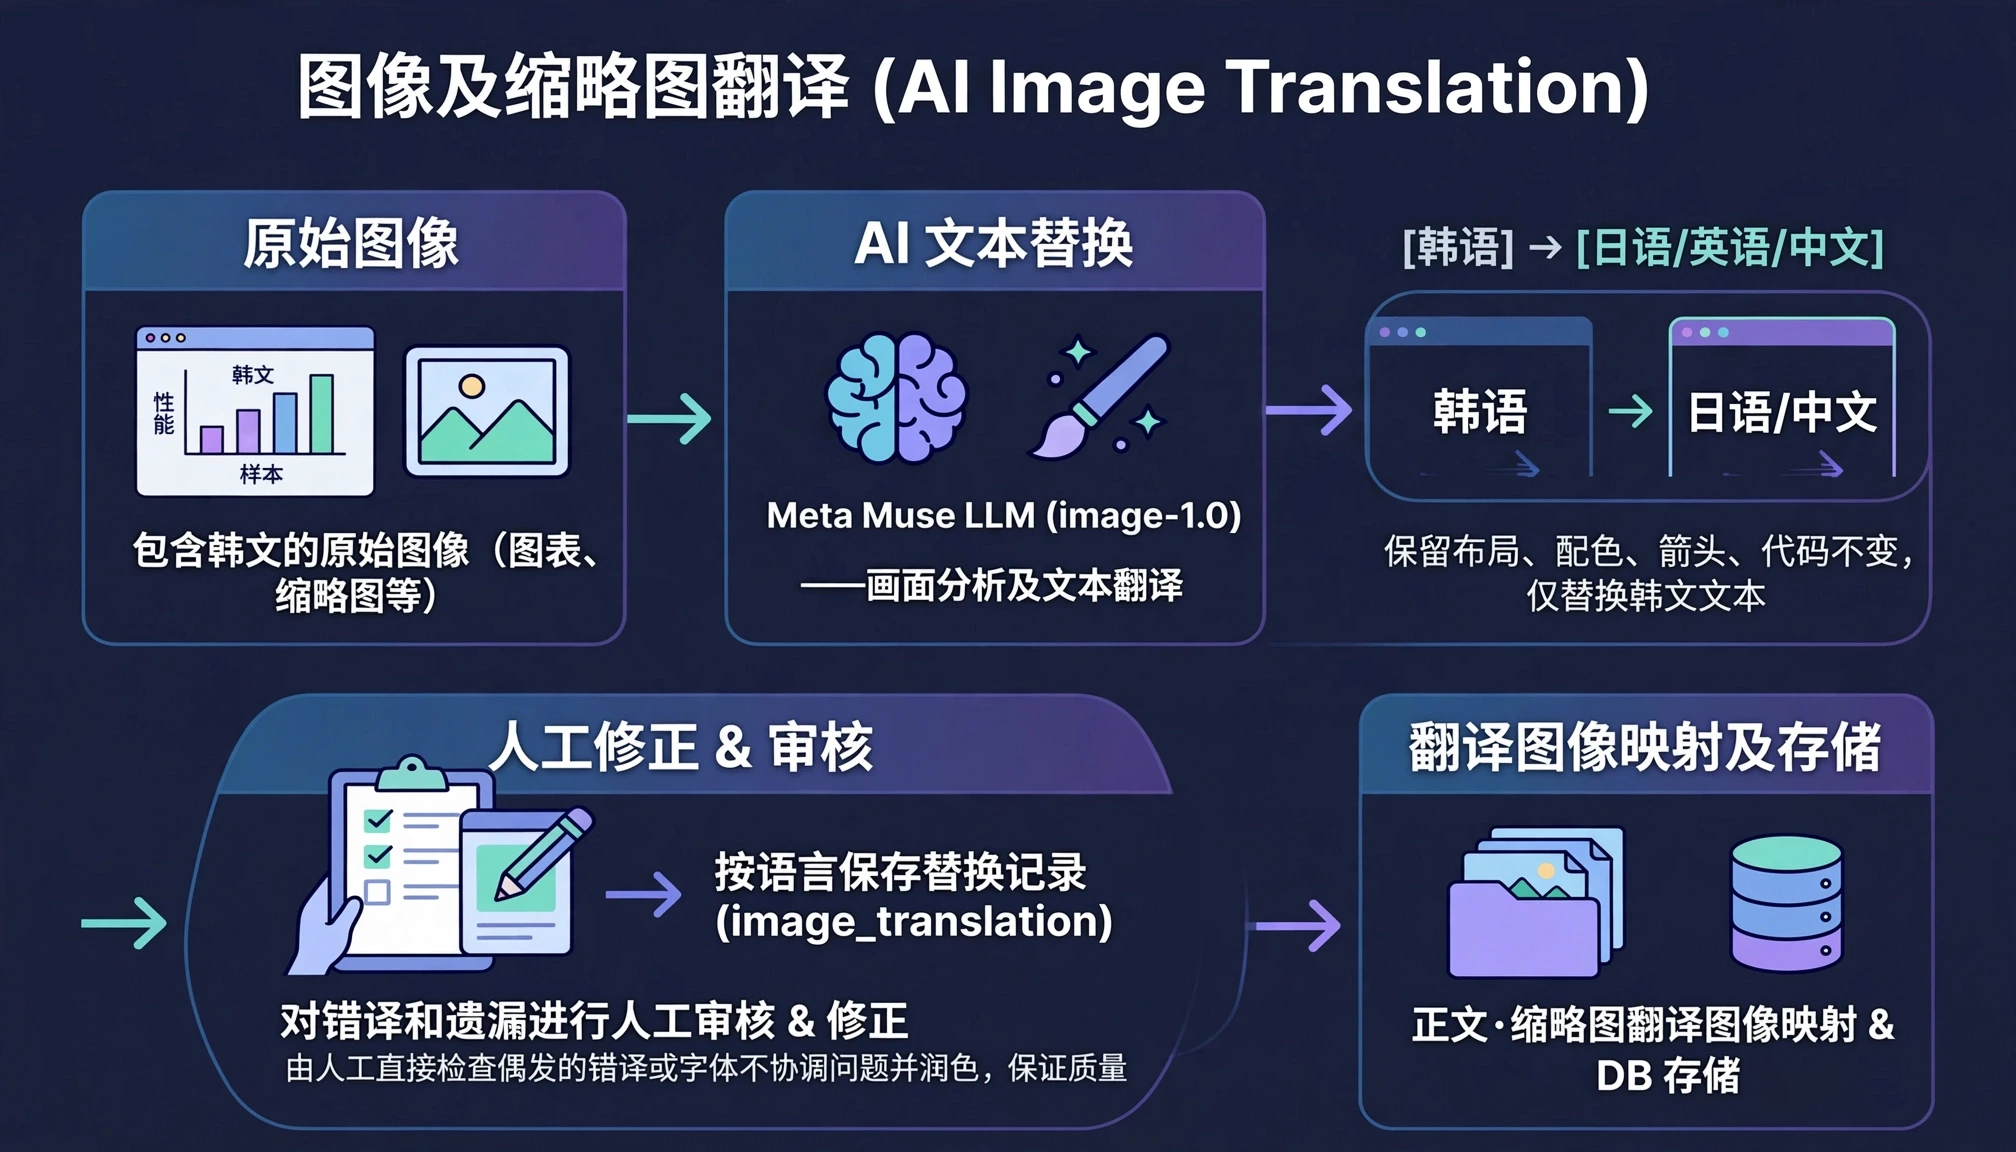
如果只翻译文字,正文中的图表、截图和缩略图里的韩文就会原样保留。因此我接入了图像生成/编辑 LLM(Meta Muse muse-image-1.0),让图片也被翻译成各个语言。每张图片的费用为 $ 0.01。
通过
/images/editsAPI,在保留原图布局·颜色·箭头·代码标识符的同时,只把图片中的韩文文本替换成目标语言。各语言的替换记录保存在
image_translation(source_key, lang)中,这样手动修改并保存译文时,正文和缩略图的翻译图片映射也会保持不变。
图片也可以走流水线,但偶尔会出现韩文没能正确翻译而被保留下来的情况。让 LLM 来审查可以递归地解决这类问题,但考虑到费用和质量,我选择了亲自确认并不断修改的方式。
4. 多语言搜索:用语义向量数据库复用一份韩语原文
在考虑多语言搜索时,我最先想到的是这个。
“向量数据库本来就是语义(基于含义)的数据库,那么即使语言不同,只要意思相近,应该也会落在相近的向量位置吧?”
我没有为每种语言把向量数据库复制 4 份,而是相信支持多语言交叉嵌入的 Weaviate 模型(Snowflake/snowflake-arctic-embed-l-v2.0),只索引一份韩语原文,直接用 4 种语言的搜索词进行向量搜索。
flowchart TB
  Req["搜索请求 (?q=&lang=)"] --> Norm["Unicode 规范化"]
  Norm --> Branch{"请求语言"}

  Branch -->|"ko"| KoVec["Weaviate 混合检索 (α = 0.75)"]
  Branch -->|"en / ja / zh-CN"| EnVec["Weaviate 纯向量 (α = 1.0)"]

  KoVec --> KoDB["查询韩语公开文章"]
  EnVec --> EnDB["公开译文过滤 · 分页"]

  KoDB -.->|"失败 · 0 条回退"| PgKo["PostgreSQL pg_trgm"]
  EnDB -.->|"失败 · 0 条回退"| PgEn["译文 pg_trgm"]
4 种语言统一的自然语言搜索流程
Unicode 搜索词清洗:原有的正则表达式只保留韩文和英文,导致日语·中文搜索词被整个删除,我把它改成了基于 Unicode 字母·数字的规则。
分离韩语与外语的权重:韩语使用向量 + BM25 混合检索(
alpha = 0.75),而对外语来说韩语 BM25 反而会干扰,所以用纯向量(alpha = 1.0)选出候选文章 ID,再只筛选出该语言的公开译文返回。没有结果或向量搜索失败时,会回退到 PostgreSQLpg_trgm关键词搜索。
5. 实际运行后暴露的局限与应对
做到这里并实际翻译了一些文章后,我清楚地看到了仅靠自动化无法做到完美的两个局限。
为了不破坏代码语法,代码块内只挑选注释·字符串模式进行翻译,因此落在模式边界上的部分代码块注释中的韩语有时没有被翻译而原样保留。
图像生成 LLM 有时改不了图表中的小号韩文,或者出现文字破损。我确认过,让另一个 LLM 审查修改后的图片并重试可以解决问题,但布局和字体的质量仍可能显得不自然。
因为这两个问题,我也做了手动修改、替换译文和翻译图片的功能。如果预算充足,我认为还可以让 LLM 进行审查并重新翻译,从而提高质量。
结语
虽然还有代码块注释漏译、图片翻译质量这类需要打磨的地方,但在每月免费额度内持续运营 4 种语言博客、尝试吸引海外流量的基础已经足够完善了。
希望这次新增的功能能让博客的读者更多。