
目录 (8)
【博客简介】打造零停机(蓝绿)部署
本文由[人类 50%,人工智能 50%]撰写。
昨天,我将博客后端从 AWS Lightsail 迁移到了 GCP 首尔区域,甚至还设置了 GitHub Actions 自动部署。
自动化部署让事情变得更便捷,但仍然存在一个缺点。每次部署时,现有的 Spring 容器都会被关闭,然后启动一个新的容器。虽然更换容器本身只需要一秒钟,但 Spring Boot 在新容器中完全启动却需要大约 20 到 30 秒。在此期间,如果访客尝试访问网站,则会发生 502 错误,并且当前正在处理的请求可能会被中断。
在这篇文章中,我解释了如何在只有一个 2GB 内存服务器 (e2-small) 的环境中创建零停机时间的蓝绿部署,并总结了我在构建它时考虑的本地缓存 (Caffeine) 和安全关机 (Graceful Shutdown) 。
有三个目标。
分发过程中不应有丝毫停顿(502)。
已经提交并正在处理的请求必须完成才能关闭。
如果新版本出现问题,只需取消部署即可,不会影响现有服务。
为什么之前的部署过程卡住了 32 秒?
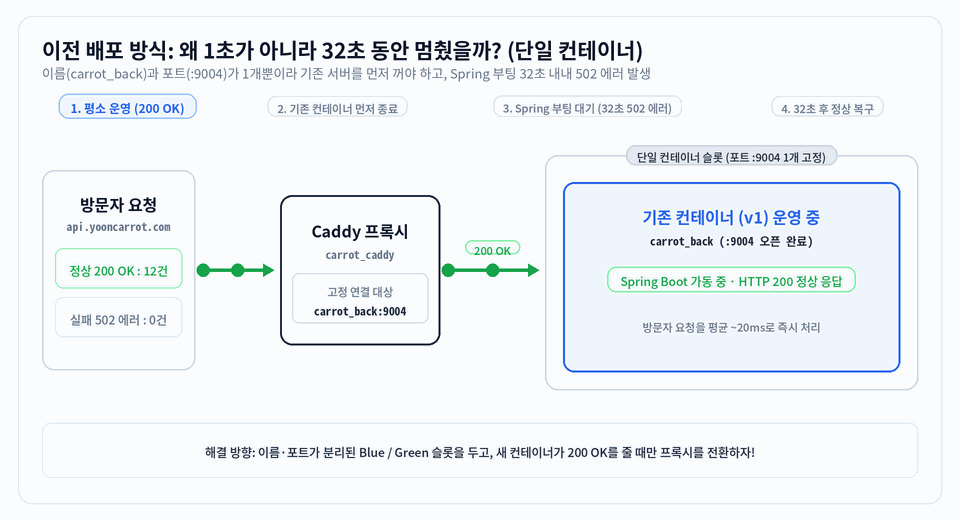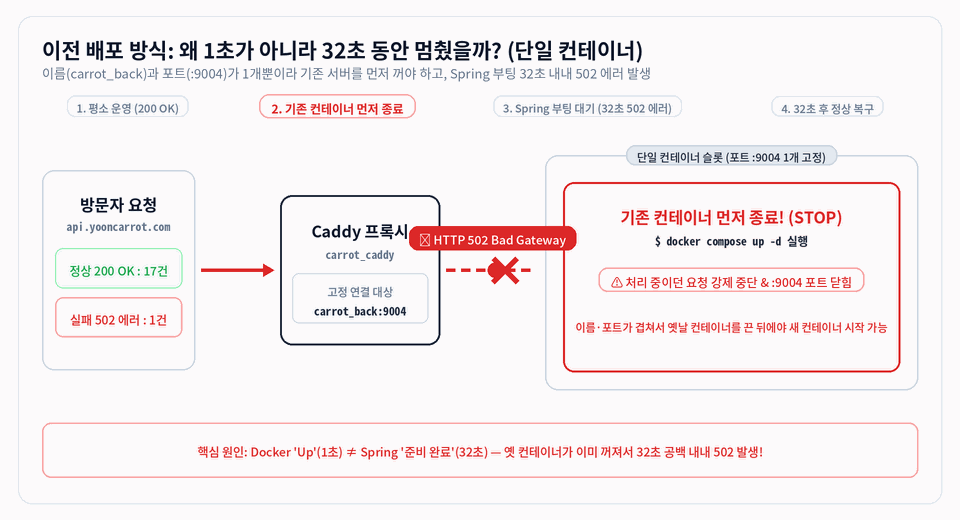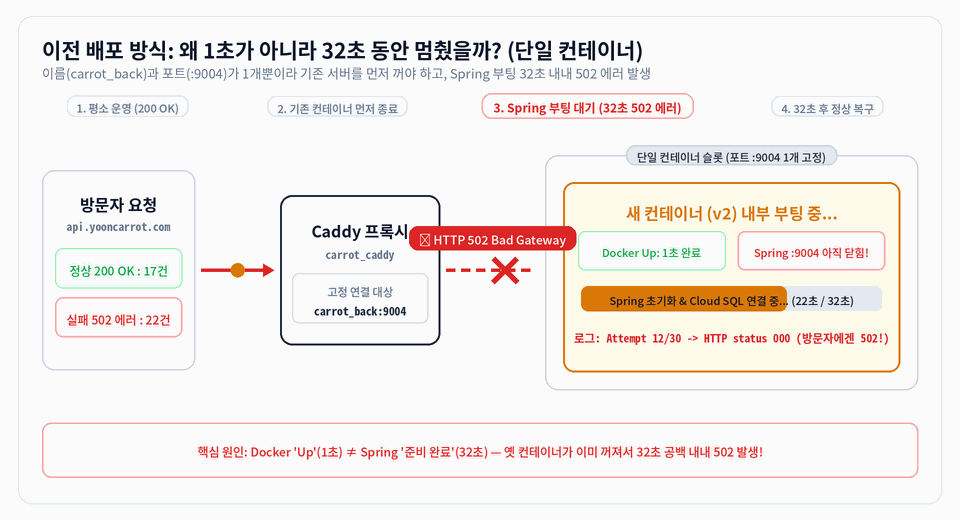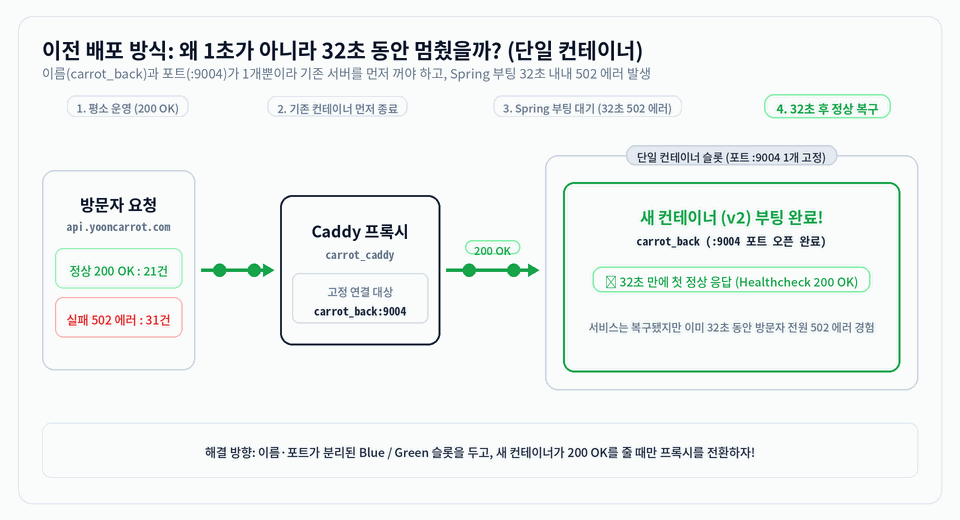
起初,人们很容易认为,“关闭容器并启动它只需要 1 秒钟,所以它只会停止很短的时间。”然而,当我实际打开在应用蓝绿部署之前运行的最后一个容器部署日志时,我发现大约有 32 秒的时间完全没有连接(502) 。
11:05:33 [deploy] Starting containers... ← 기존 carrot_back 정지 & 새 컨테이너 시작11:05:40 [deploy] Attempt 1/30: HTTP status 000 ← 아직 Spring 켜지는 중 (방문자에겐 502)...11:06:03 [deploy] Attempt 12/30: HTTP status 00011:06:05 [deploy] Healthcheck passed (HTTP 200) ← 드디어 첫 정상 응답!原因有二。
由于只有一个容器名称和一个端口,我必须先关闭旧容器。之前,名为“carrot_back”的容器只使用了 9004 端口,所以当我运行 `docker compose up -d` 命令时,必须先关闭现有容器才能启动新容器。
Docker 的“启动”状态与 Spring 的“200”状态并不相同。Docker在执行 java -jar 命令后仅需一秒钟就认为容器已启动,但 Spring Boot 在容器内读取类、建立 Cloud SQL 连接和打开端口需要超过 25 秒的时间。
由于 Spring 服务器运行了 32 秒,所有进入网站的访客都只能看到 502 错误。
更改零停机部署(蓝绿部署)
蓝绿部署方法主要有两种表现形式:始终采用 2 对 2 的部署方式;仅在必要时才采用 2 对 2 的部署方式。
始终显示 2 | 仅在需要时 2 | |
|---|---|---|
普通服务器 | 2 | 1 |
服务器部署中 | 2 | 2 |
回滚速度 | 速度非常快 | 环境再生可能是必要的 |
费用 | 高度 | 相对较低 |
可用性 | 高度 | 相对较低 |
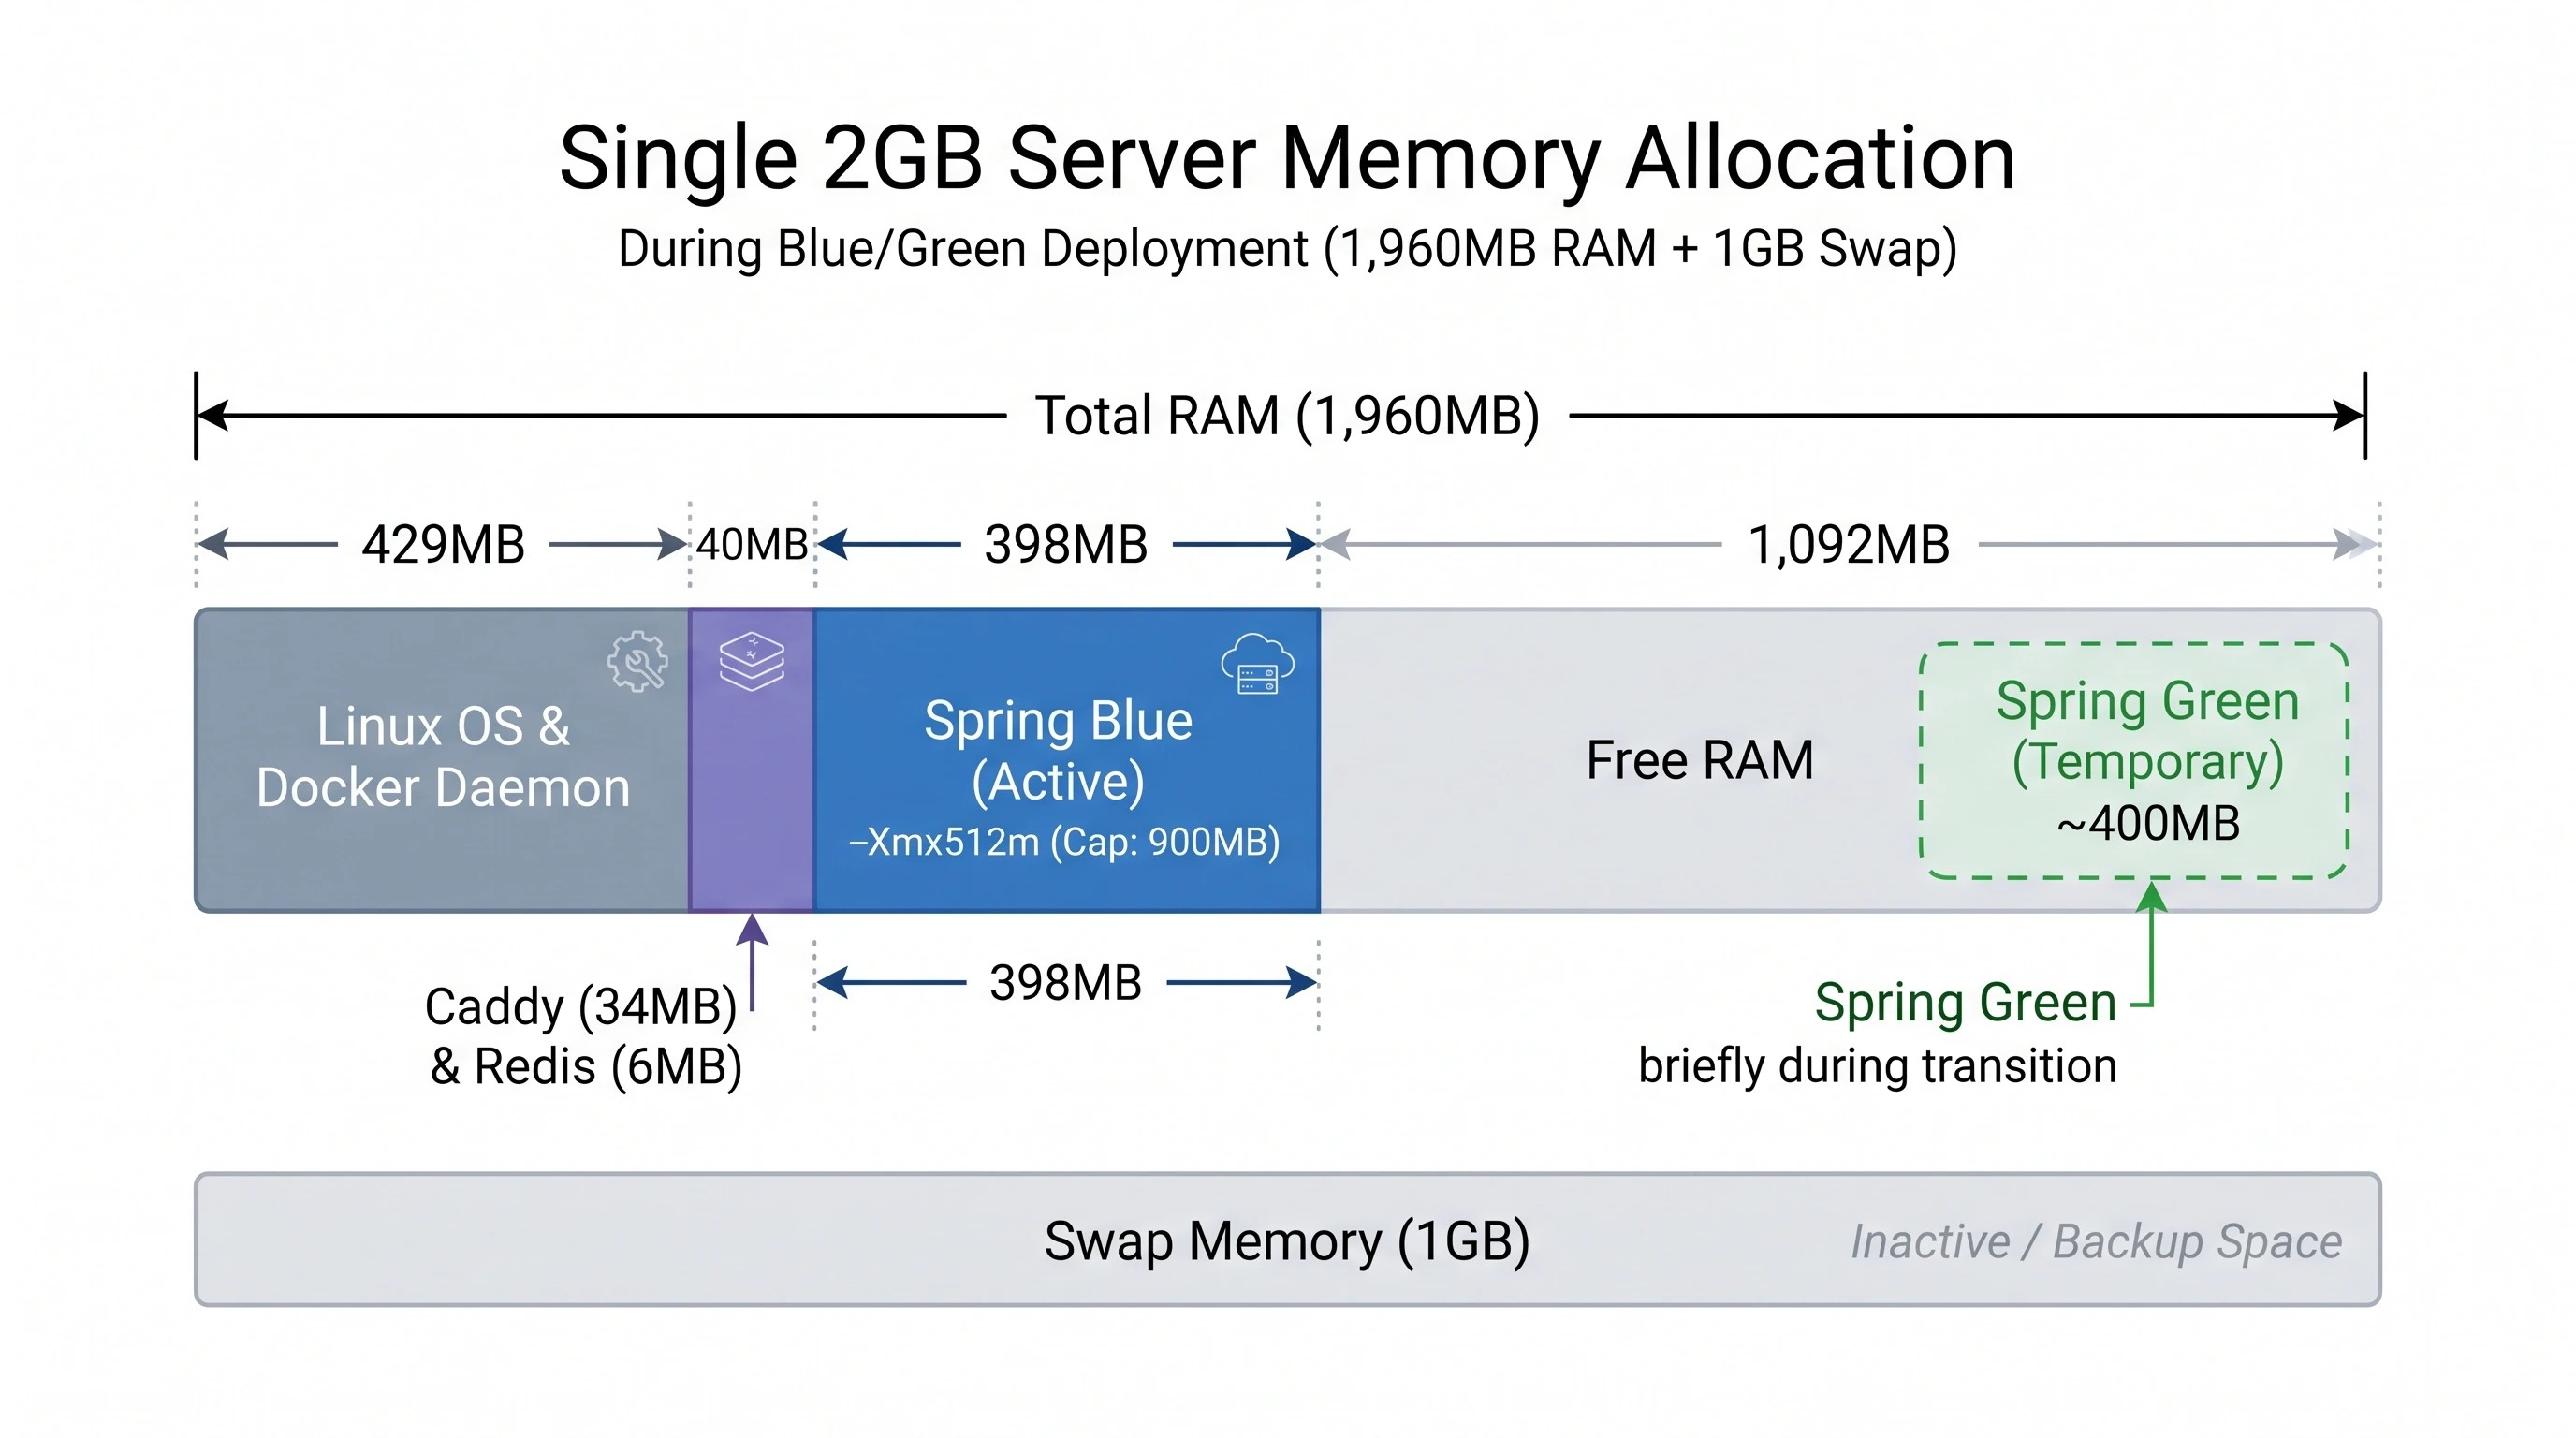
为了找出适合我的策略,我检查了我的 2GB 内存服务器的内存使用情况。
分配 | 实际内存使用情况 |
|---|---|
Spring Boot(`carrot_back`) | 约 398MB |
胡萝卜球童(`carrot_caddy`) | 约 34MB |
Redis(`carrot_redis`) | 约6MB |
Linux 操作系统、Docker 守护进程等会占用默认的系统资源。 | 约 429MB |
当前总使用量 | 约 867MB / 1,960MB(剩余可用内存约 1,092MB) |
这三个容器本身仅占用约 438MB 内存,即使加上 Linux 操作系统和 Docker 默认使用的内存(约 429MB) ,总共 2GB 内存中仍有约 1.1GB(1092MB)可用。再加上 1GB 的交换空间,足以在部署期间启动另一个 Spring 容器(约 400MB)。
但是,为了以防万一服务器崩溃,而且由于配置太低,无法不必要地运行另一个服务器,我采取了两项措施。
设置每个容器的内存上限:之前,JVM 设置中 MaxRAMPercentage 为 60.0(服务器 2GB 内存的 60%,即最多允许 1.2GB )。即使正常情况下只使用 400MB,2GB 的服务器在流量波动期间也可能无法应对。因此,我将每个容器的堆内存上限设置为 512MB(-Xmx512m,容器限制为 900MB)。
过渡完成后,关闭之前的容器:我设置的是仅在部署期间启动两个容器,而流程完成后只启动一个容器。
变更后的部署流程如下。
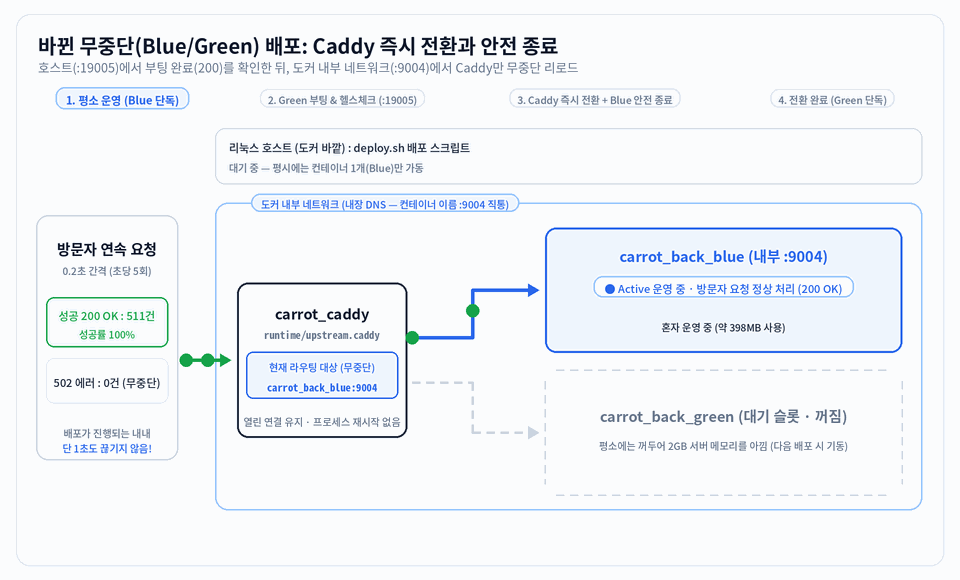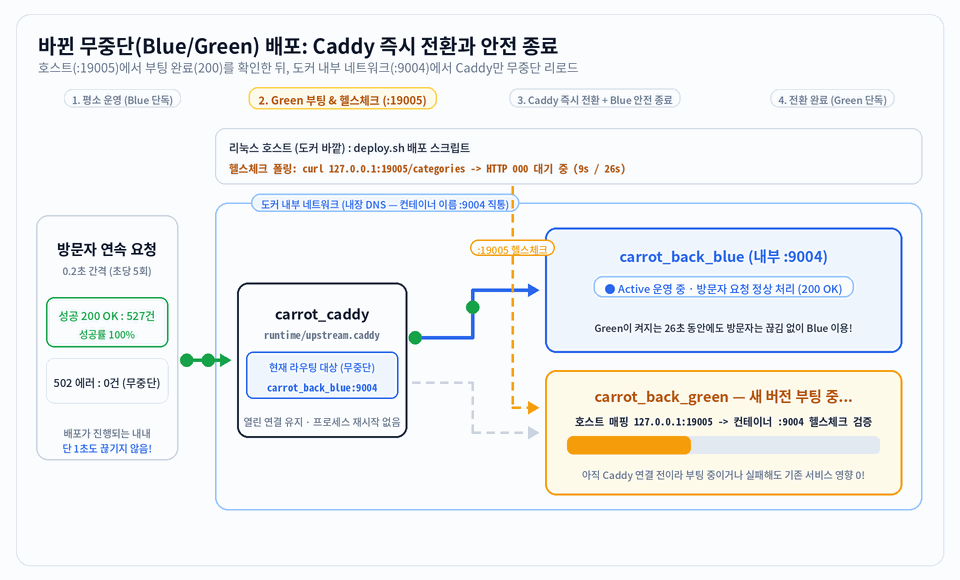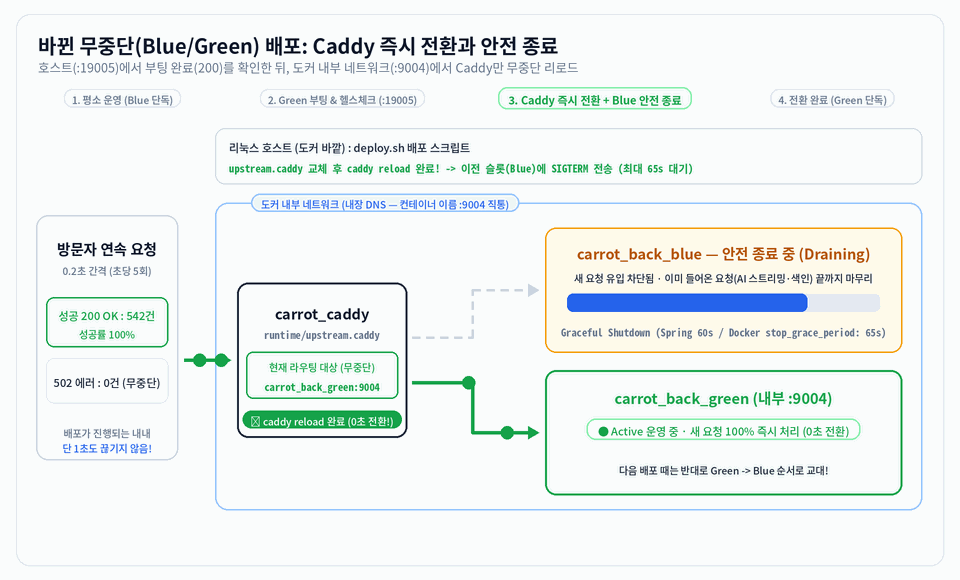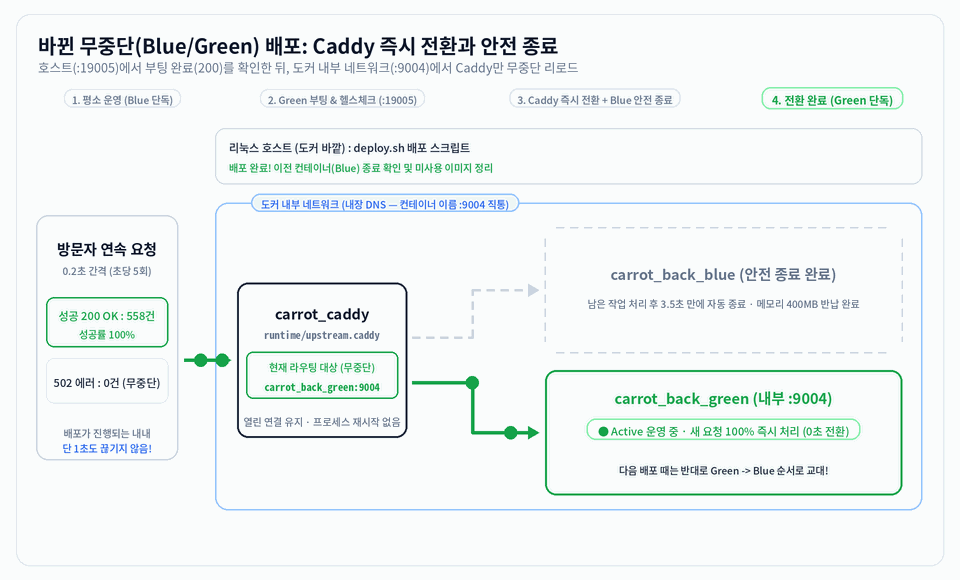
下次部署时,我们将按相反的顺序切换它们,从绿色交替到蓝色。
零停机部署的 Caddy 配置
Caddy 负责流量重定向。在本例中,Caddy 通过部署脚本使用重新加载方法在绿色和蓝色模式之间切换。
# caddy/Caddyfile (고정)handle { request_body { max_size 10MB } reverse_proxy { import /etc/caddy-runtime/upstream.caddy # 이 파일의 텍스트가 여기에 그대로 들어감 (ex. "to back_green:9000") header_up X-Real-IP {remote_host} }}部署脚本已正确地将上述 /etc/caddy-runtime/upstream.caddy 文件从绿色转换为蓝色。
部署脚本如何变化
检查当前容器颜色
漂浮一个不同颜色的新容器
对新容器运行健康检查,直到其达到 200。
将 upstream.caddy 文件的地址替换为新容器的地址。
重新加载 Caddy 以反映设置
移除之前的容器
如果在容器替换过程中发生错误,则继续写入现有容器。
完成现有请求(优雅关闭)
即使启动了新容器,也不应立即移除现有容器。在切换前 0.1 秒到达的请求,或者正在积极写入文本的AI 草稿流 (/ai/*) ,都可能在中途被中断。
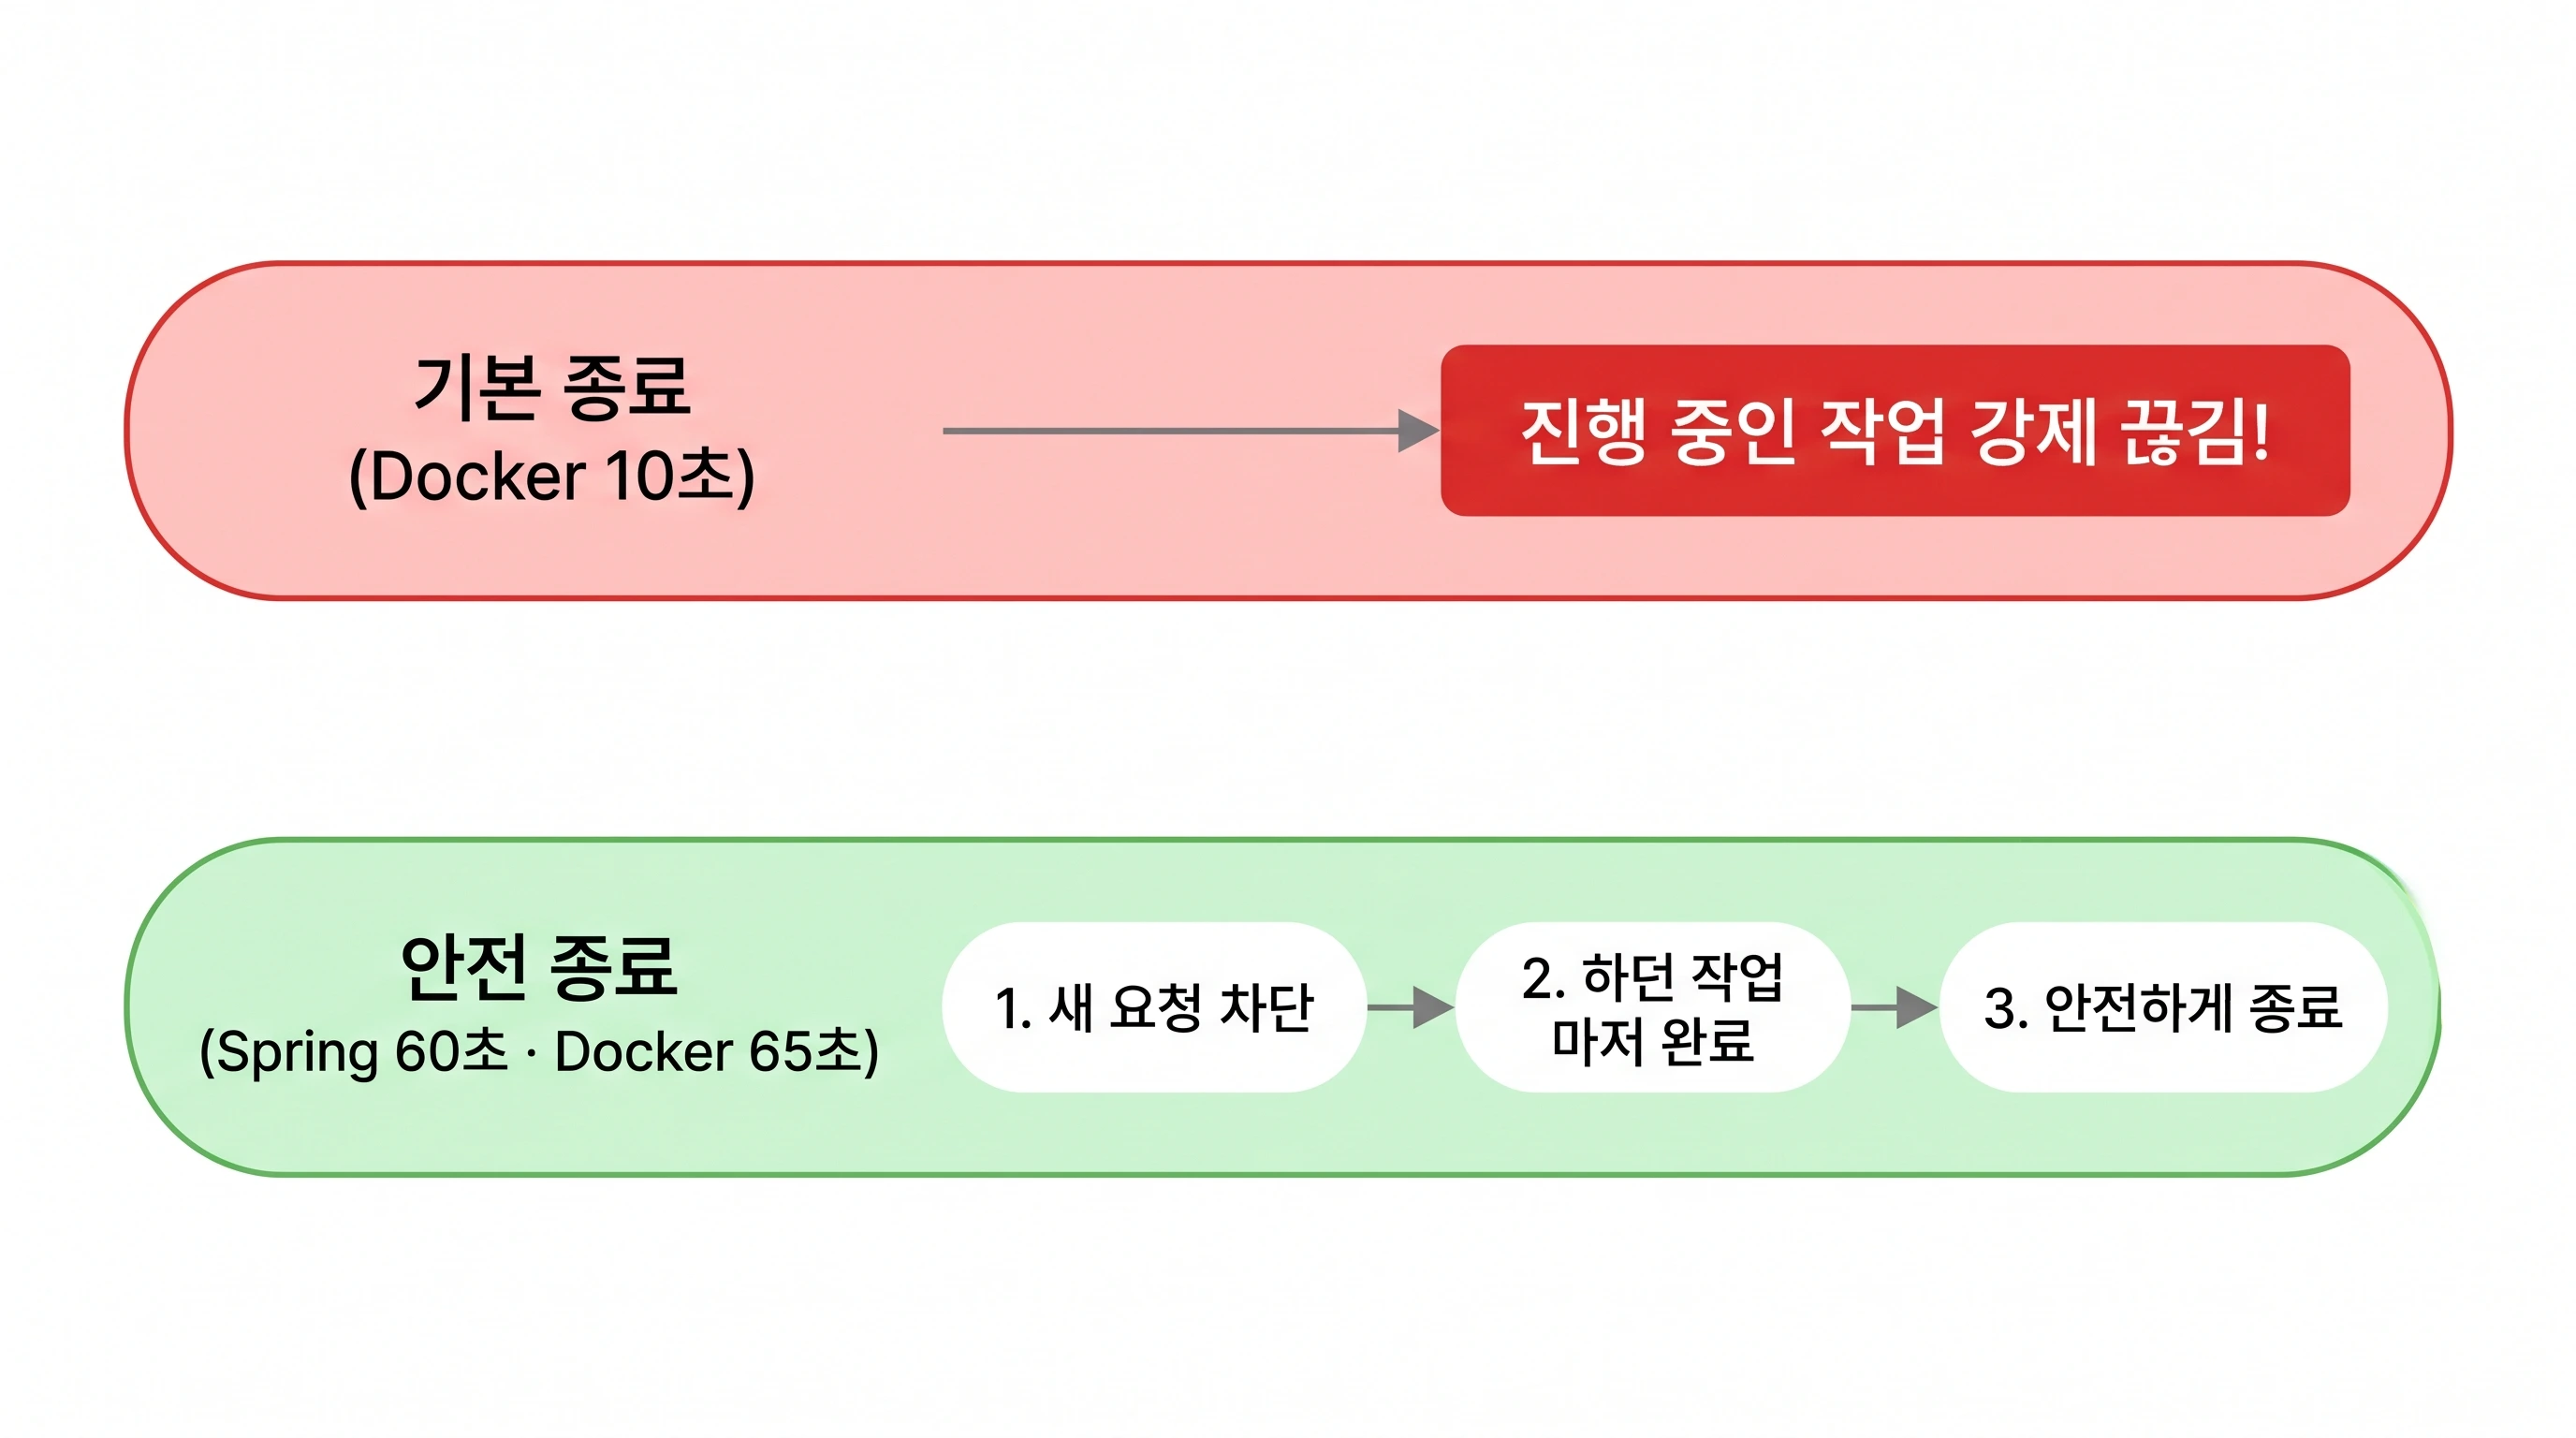
所以,你需要进行配置,使服务器终止现有请求并关闭。
部署脚本在 caddy 重新加载完成后向现有容器发送终止信号 (SIGTERM)。
我在 Spring Boot 配置中添加了 `server.shutdown: graceful` 并将最大等待时间设置为 60 秒。我还修改了 Docker 的等待时间(`stop_grace_period: 65s`)。这样,Docker 就可以处理传入的请求 60 秒。
即使 Web 请求已完成,Weaviate 向量索引仍可能在后台线程 (articleIndexExecutor) 中运行,因此我将其设置为最多等待 30 秒以完成此任务,然后再关闭 (waitForTasksToCompleteOnShutdown)。
检查本地缓存(Caffeine)是否存在任何问题。
这是我在使用人工智能时没有考虑到的。如果你使用 Redis,很可能无需担心这个问题,因为它是一个与 JVM 隔离的本地缓存。但是,如果你使用 Caffeine,Green 和 Blue 不会共享内存,因此它们会被初始化。
因此,我测试了使用 Caffeine 的数据流在服务器全新初始化后启动时会受到哪些影响。如果确实存在影响,我准备将它们迁移到 Redis。
保存位置 | 包含的数据 | 在蓝色和绿色之间切换时 |
|---|---|---|
共享的 Redis 容器 | 登录刷新令牌、尚未合并到数据库的视图、AI/搜索每日限额 | 共享并按原样维护(登录后不会退出登录,数据不会丢失) |
每个 JVM 内部都含有咖啡因 | 文章详情、分类列表、网站地图、自然语言搜索排名(所有信息将在 10 分钟后过期) | 未共享(新容器初始为空) |
按照上述方法检查数据后,我发现如果 Caffeine 中缺少数据,我可以直接从数据库中检索并填充。当然,响应速度会因为与数据库通信而有所降低,但我认为这不会造成显著影响。
绿/蓝灯切换后,它真的连一秒钟都没断电吗?
设置完成后,我们通常如何验证“零停机部署”是否成功?由于部署完成后仅通过浏览器访问网站无法发现过渡期间是否短暂出现过 502 错误,因此我们会通过在整个部署过程中持续发送外部请求并测量成功率和响应时间来验证这一点。
这一次,在再次运行实际的蓝→绿生产部署时,我尝试从我的电脑以0.2 秒的间隔(每秒 5 次)连续调用它约 2 分钟。
12:53:55 [deploy] Active slot: blue -> Target slot: green (127.0.0.1:19005)12:54:10 [deploy] Starting candidate container carrot_back_green...12:54:12 [deploy] Polling healthcheck on http://127.0.0.1:19005/categories (max 90s)...12:54:12 [deploy] Attempt 1/45: HTTP status 000, retrying in 2s...... (새 Spring Boot가 켜지는 약 26초 동안, 방문자는 계속 carrot_back_blue 이용)12:54:38 [deploy] Healthcheck passed on attempt 13 (HTTP 200).12:54:38 [deploy] Validating and hot-reloading Caddy -> carrot_back_green:9004...12:54:39 [deploy] Traffic switched to carrot_back_green.12:54:39 [deploy] Gracefully draining and stopping previous slot: app-blue (up to 65s)...12:54:42 [deploy] Blue/Green deployment complete (active: green). Pruning unused images...您可以在下表中看到结果。
分配 | 现有部署(单容器) | 蓝/绿分布(实际测量) |
|---|---|---|
部署期间的暂停时间 | 大约 32 秒(11:05:33 → 11:06:05) | 0 秒 |
连续请求成功率 | 32 秒部分,全部失败 (502) | 558 / 558 次成功(100%,0 次失败) |
响应时间(分钟/p50/p95/p99/最大值) | - | 14.1 / 19.5 / 30.2 / 52.1 / 993.7 毫秒 |
在过渡时刻之前,没有出现任何 502 错误。558请求没有一个被中断,不仅在绿灯亮起的 26 秒内,而且在球童重新加载的 12:54:38 到 12:54:39 秒之间也是如此。
993.7毫秒的最大值出现的原因:在558个请求中,只有2个请求的耗时超过100毫秒。值得注意的是,993.7毫秒的最长耗时恰好出现在Caddy重新加载后的瞬间,当时green正在从空缓存中读取Cloud SQL的第一条帖子列表。紧接着,0.2秒后的请求耗时61.1毫秒,再下一个请求耗时23.7毫秒,速度随即恢复正常。
之前的容器清理也用了 3.5 秒完成。app -blue 在 12:54:39 收到关闭信号后,完成了剩余的处理,并在 12:54:42 完全停止运行。
现在,每次部署,我们都可以交替使用蓝色→绿色→蓝色,确保访客分布不间断。
我收获的东西以及我未来想尝试的事情
我这次的收获
部署过程中的暂停时间已变为 0 秒。我感到非常自豪!!虽然现在还没有用户,但这无关紧要,但我还是感到自豪。
它不会中断正在进行的请求。在转换过程中,它会完成转换前正在进行的所有请求或索引任务。
部署失败不会导致服务中断。即使新版本未启用,旧版本仍会继续提供服务。
额外费用为0韩元。
未来我想尝试的事情:金丝雀发布
由于访问量较小,而且目前我只有一台服务器,我认为蓝绿部署是最佳选择,因为它能实现一次性平滑过渡。实际上,使用 Caddy 的加权路由或 cookie 残留功能可以让我模拟金丝雀部署,即使在单台服务器上也只将部分流量发送到新版本;然而,考虑到我目前的服务规模和用户数量,这些功能几乎毫无用处。作为一名开发人员,我无法接受尝试金丝雀部署的决定……
以后,当我的博客或新服务发展壮大,用户数量增加,服务器数量扩大时,我肯定会尝试在实践中应用 Canary 部署。