
目录 (15)
每月只需 0 韩元,即可为您的博客添加自然语言搜索功能。
我原本以为,如果在博客搜索栏中搜索“MD 和 HTML 的区别”就能找到题为“ [AI 编码] 关于 MD 和 HTML 格式的思考”的文章,那就太好了。然而,当我按照上述方法搜索时,博客上并没有出现任何文章。
在这篇文章中,我总结了将自然语言搜索(根据句子含义查找帖子)添加到之前仅支持关键词搜索的个人博客的过程。
有两个目标。
即使只有 2 个虚拟 CPU/4GB 内存,也必须能够进行向量嵌入和向量数据库搜索。
你不应该额外花钱。
关键词搜索导致难以找到所需文章
最初的搜索是使用 MySQL 进行全文关键词搜索。如果您知道确切的关键词,这种方法效果很好,但读者通常会根据遇到的问题而不是关键词进行搜索。
“我的登录信息总是被登出” → 搜索: JWT 刷新令牌轮换
“帖子已保存,但屏幕未更新” → 搜索: Next.js 缓存失效
所以我需要一个能够查找含义相似的文本的搜索功能。
我不想为了一个访问量不大的博客花更多的钱在服务器上!
服务器配置在同一平台上运行 MySQL、Redis、Spring Server、Jenkins 和 Nginx。因此,添加 Vector DB 带来了相当大的负担,因为我们还需要确保足够的内存来处理传入的请求。(尤其是在 Jenkins 构建期间,剩余内存不足 500MB。)
于是,我开始寻找提供免费矢量数据库和嵌入的云服务。就这样,我找到了Weaviate Cloud 的免费套餐。
您可以免费存储 1GB 内存/10GB 固态硬盘/10 万个矢量对象。此外,每天还可免费进行 2000 次嵌入,每月可免费进行 1000 次 RAG 搜索。
考虑到每日访客数量和帖子数量,我认为免费套餐已经足够了。
抱着它随时可能消失的心态
我当时想,既然 Weaviate 免费服务器是免费的,那它随时都有可能出现故障或宕机。所以,我实现了一个备用方案,让它能够使用现有的 MySQL 关键字搜索功能继续运行。
文本的来源始终是 MySQL。
即使载体库为空或停止运行,搜索也不应失败。在这种情况下,请改用关键字搜索。
即使索引消失了,您也可以通过一次 Admin API 调用重新创建它。
整体结构
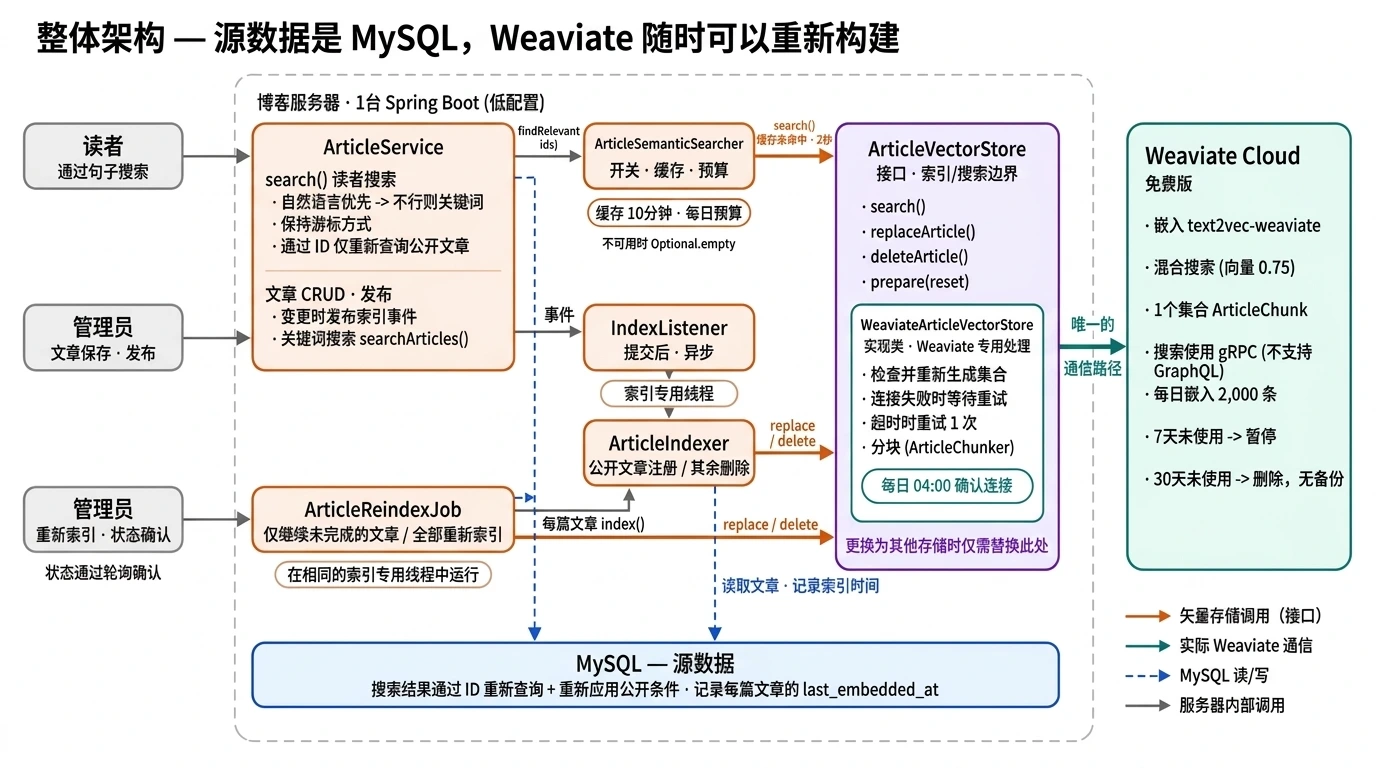
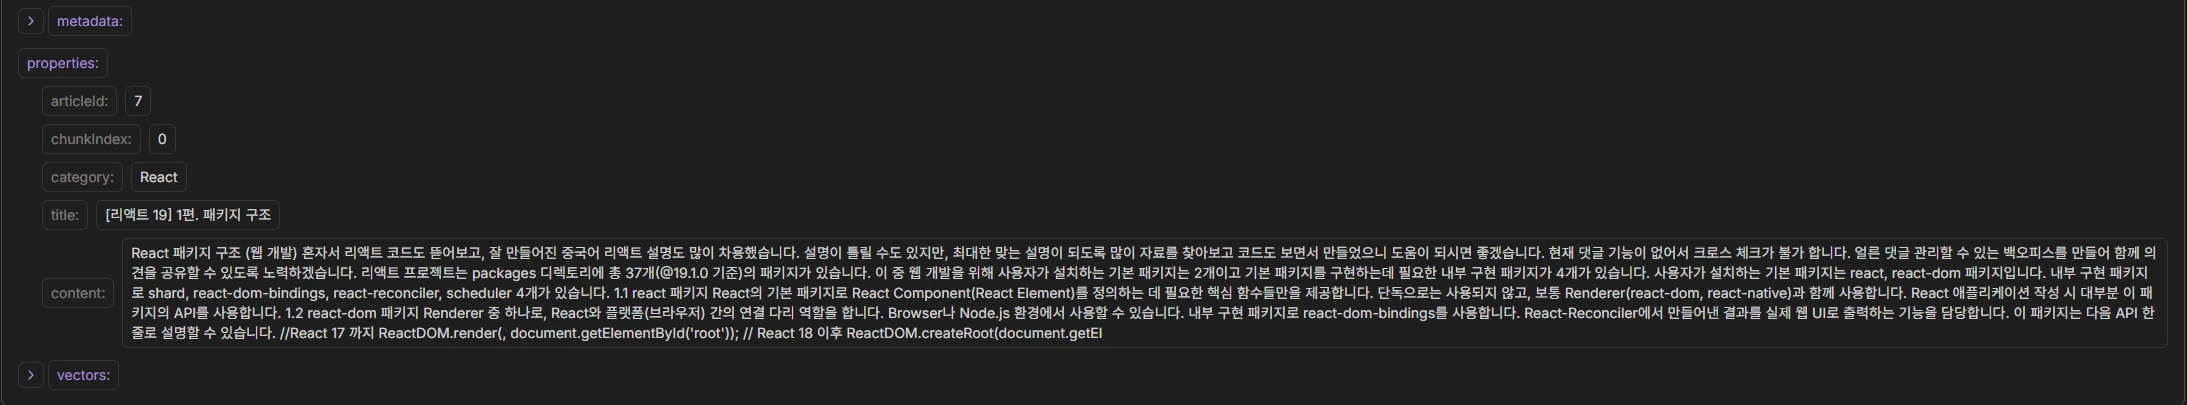
Weaviate会将文章标题、正文片段、分类和文章编号存储在一起。标题和正文用作比较含义的素材,分类用作筛选条件。然而,搜索结果中唯一检索到的信息是“哪篇文章与这句话的含义最接近”。诸如标题和缩略图等卡片信息不会从 Weaviate 中获取,这些信息将显示在屏幕上。
MySQL实际上会返回要显示的帖子。它还会根据 MySQL 信息检查帖子的可见性,从而对帖子进行筛选。
这样一来,即使向量库略有延迟,私有或已删除的帖子也不会出现在搜索结果中。卡片始终显示最新的 MySQL 内容。
如何为文本建立索引
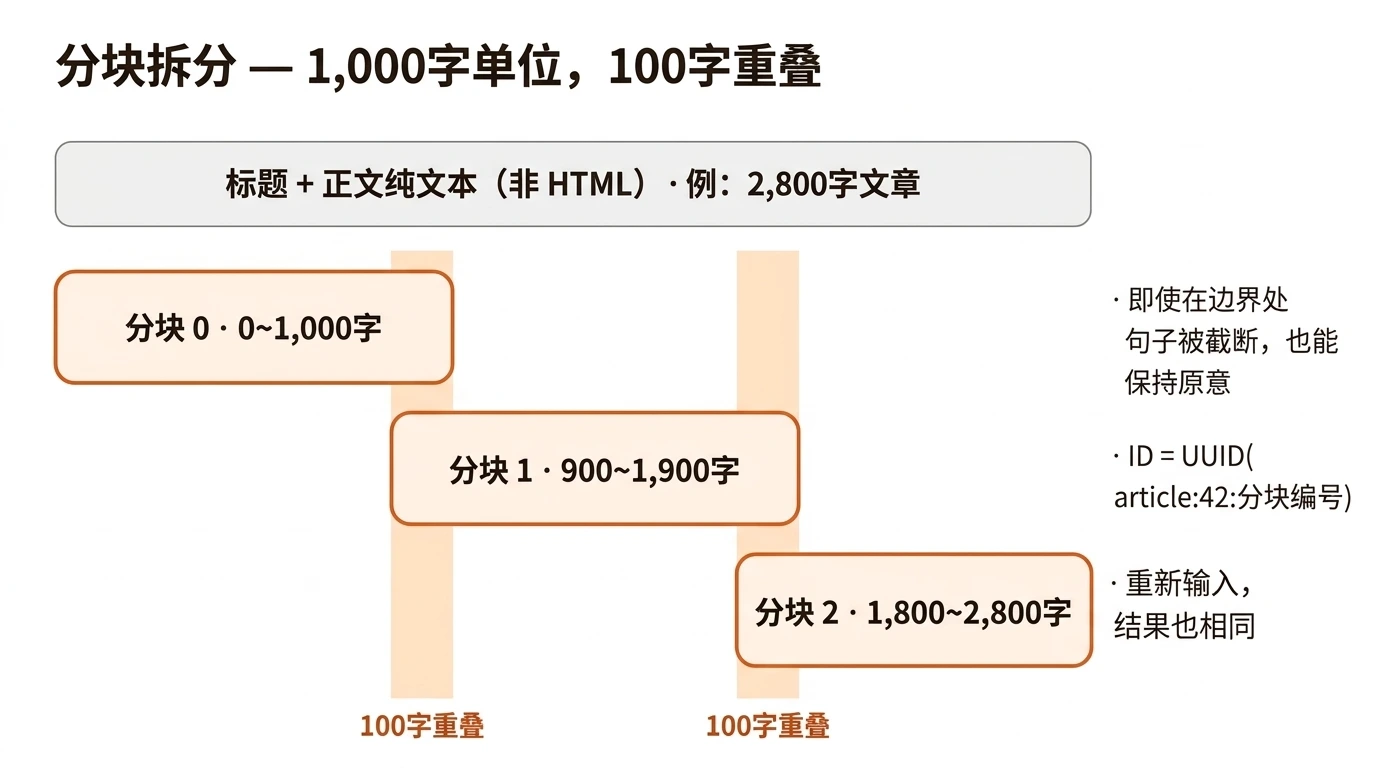
如果嵌入整篇文章,文本越长,中间的内容就越容易被淹没。所以我会在插入之前将文本分成几个部分。当然,最好能建立一套评估标准,确定最佳的字符分割比例,并检查效果提升了多少,但我没有这样做,因为在个人博客上进行这样的测试未免过于繁琐。
请使用纯文本,不要使用 HTML。纯文本是指编辑器保存时会移除 Markdown 符号的文本。
我机械地将文本分割成1000个字符的单元,并将前后两部分重叠100个字符。我的目的是确保即使是在边界处被切割的句子,也能在其中一部分上保留其周围的上下文。
请同时提供标题。网站需要能够仅通过标题中的关键词进行搜索。
为每个创建的片段分配一个 UUID,格式为文章:{文章编号}:{片段编号}。当文章被编辑时,删除所有使用该文章 ID 注册的片段,然后重新注册。
Weaviate 仅为每件产品存储此信息。
属性 | 使用 |
|---|---|
articleId,chunkIndex | 删除时找出是哪段文本的哪个片段 |
类别 | 按类别筛选 |
标题、内容 | 转换为矢量图 + 三元组关键词搜索 |
如果文本发生变化,索引也会相应变化。
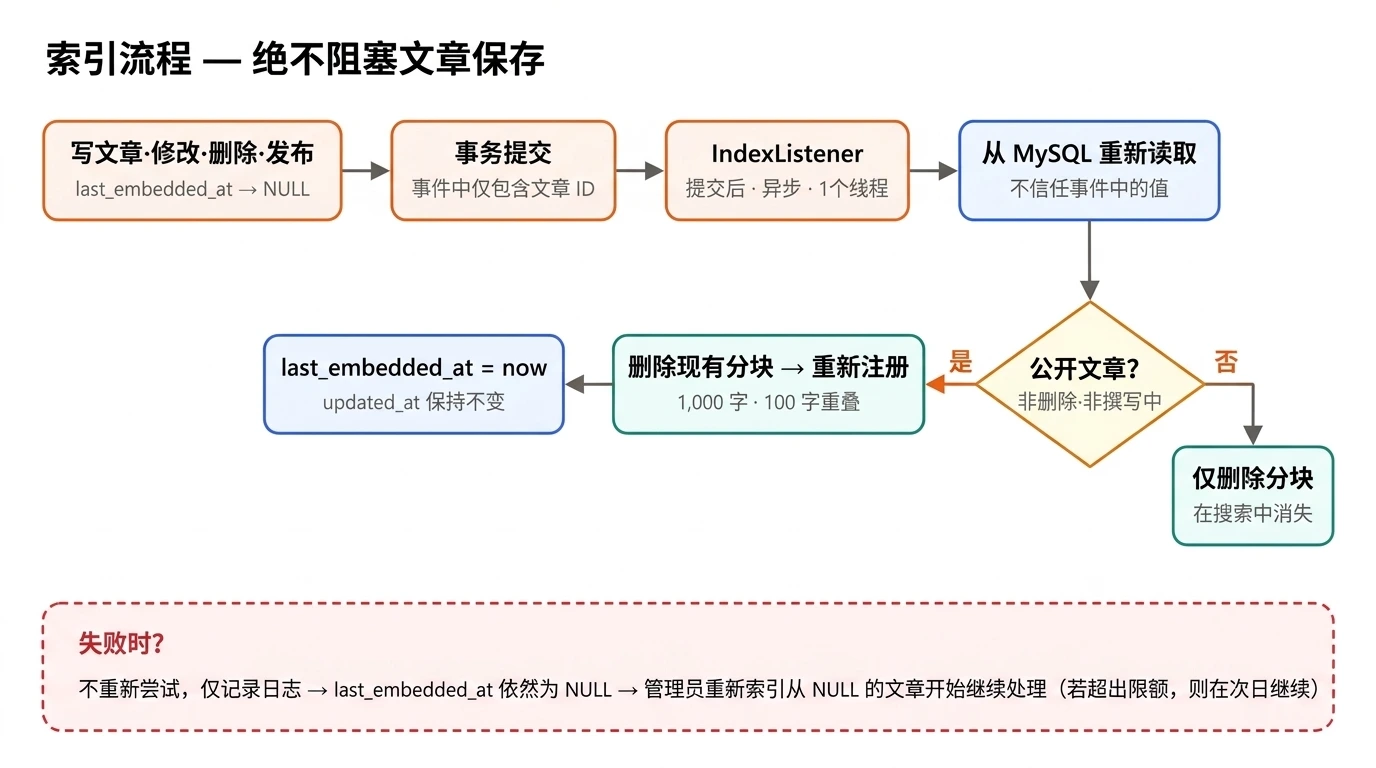
当帖子被编辑或删除时,现有的向量索引会被移除并重新创建。其工作原理如下。
1. 我们绝不会阻止文章保存。索引操作是在保存(提交)完成后独立运行的。即使 Weaviate 运行缓慢或暂停,文章也会被保存。从一开始,我们就明确指出:“如果由于 Weaviate 的原因导致文章保存失败,那就是设计缺陷。”
2. 我们只用一个线程运行索引。由于服务器规模较小,我们不能让索引占用处理读者请求所需的资源。
3. 处理过程中再次读取数据库。事件中仅存储帖子编号,实际状态会在 MySQL 中再次验证。(检查 MySQL 中的索引状态)
4. 即使失败也不会重试。它只会保留日志,恢复工作只能通过手动重新索引来完成。
记录哪些文本已被索引。
我在每篇文章中添加了一个 last_embedded_at 列,并像这样编写。
价值 | 意义 |
|---|---|
时间 | 它已根据当时的最新内容进行了索引。 |
无效的 | 它还没有被索引,或者你需要重新索引一次。 |
当需要创建索引时(例如更新或发布操作),last_embedded_at 的值会被清除为 NULL。然后,该值会被用作判断是否需要创建索引的依据。
如何搜索
搜索流程
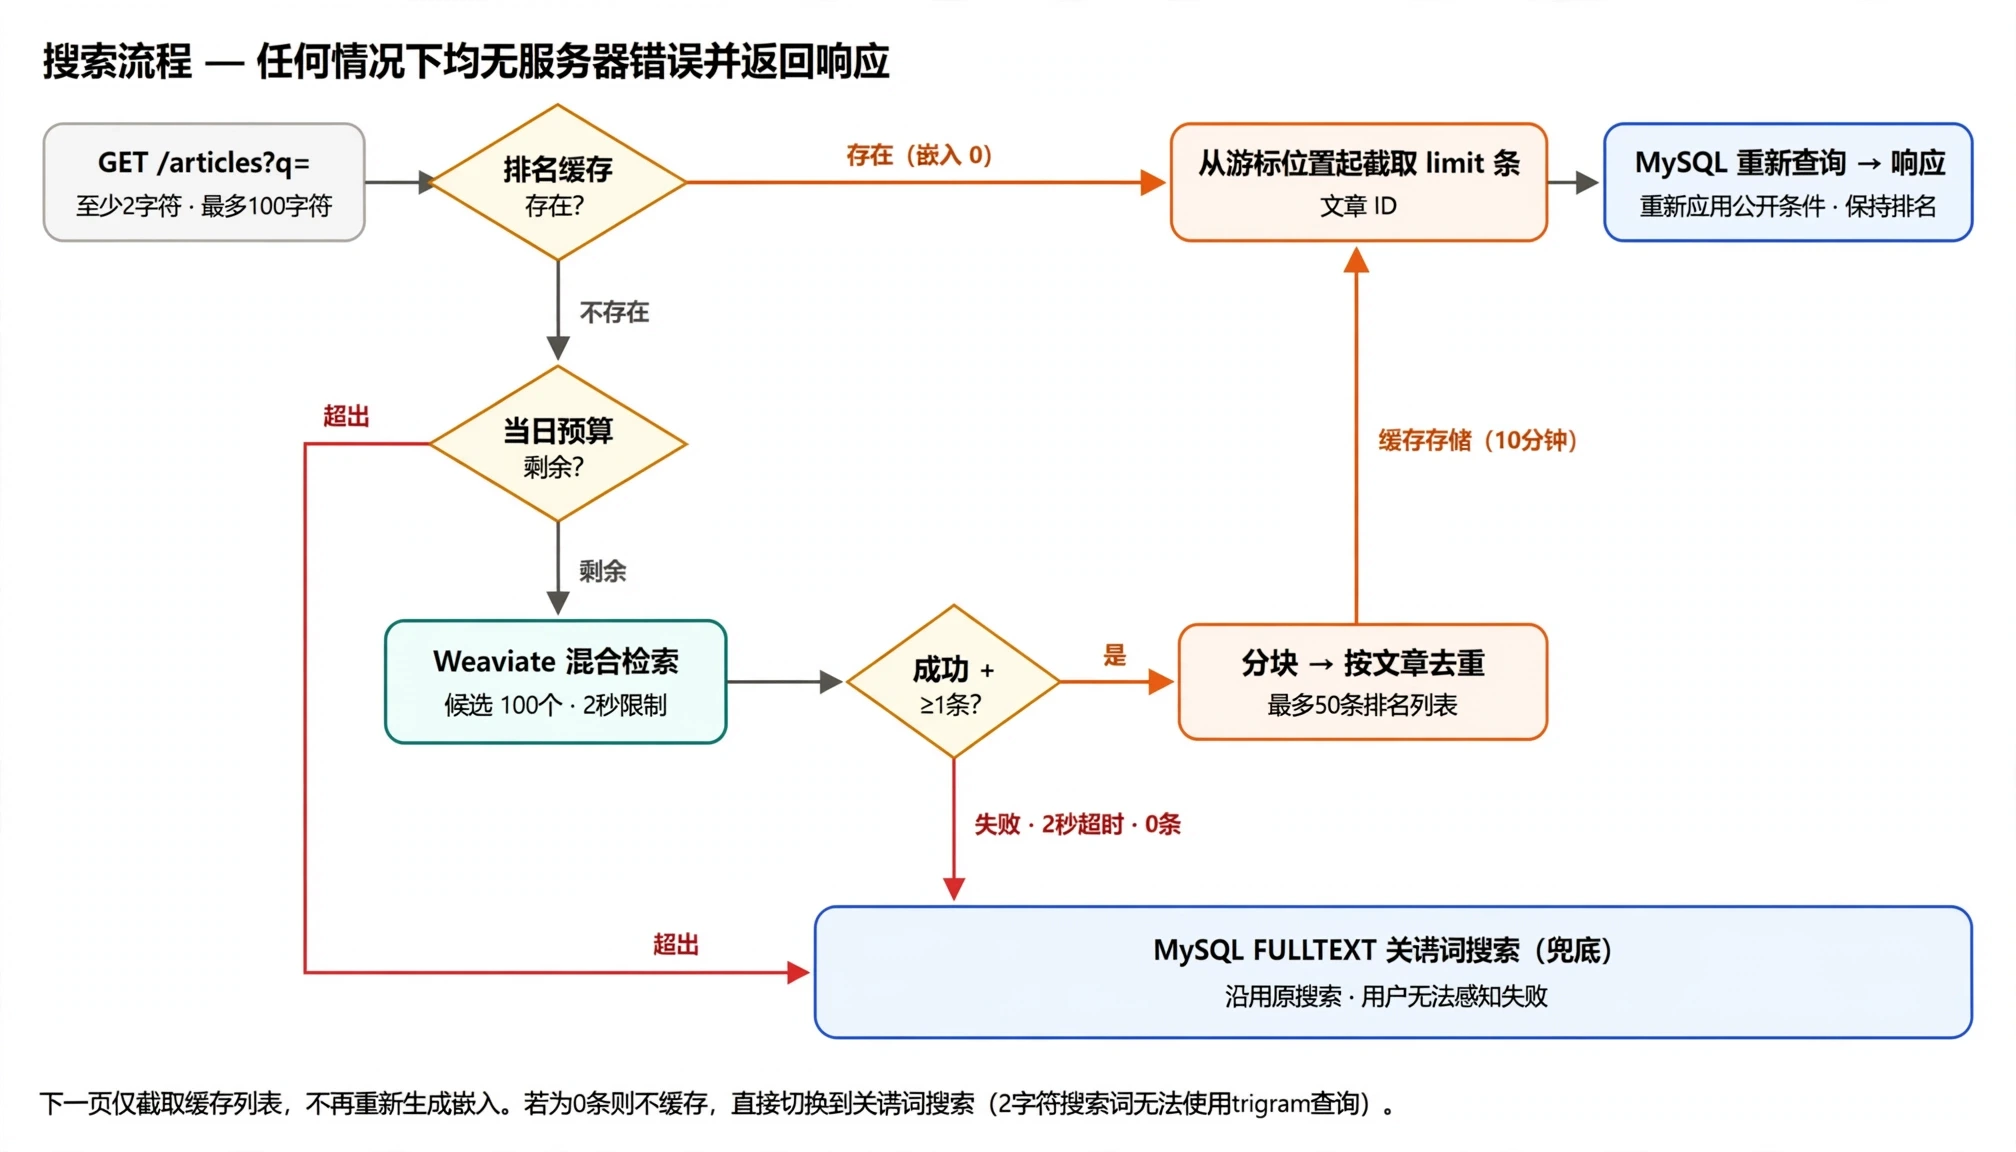
请检查搜索词。搜索词长度至少为 2 个字符,最多为 100 个字符。
检查缓存中是否存在使用相同搜索词(和类别)创建的排名列表。如果存在,则跳过嵌入步骤,直接进入步骤 4。
如果没有足够的可用资源,请检查今天是否有足够的资源,并在 Weaviate 中搜索(向量搜索占 75% + 关键词搜索占 25%,100 个候选结果,2 秒搜索时间限制)。将基于片段的结果合并成最多包含 50 个排名项目的基于帖子的列表,并缓存 10 分钟。
从光标位置开始截取所需数量的帖子,并从 MySQL 数据库中检索它们。重新检查隐私条款并维护排名。
它的响应格式与现有关键词搜索的格式完全相同。
我当时的想法是,最好缓存现有的搜索词,以便实现分页或无限滚动。否则,它们会一直嵌入页面。这就是这个流程的由来。
我几乎没怎么改动前面部分。
我们完全按照现有关键词搜索的格式调整了响应格式,因此搜索结果页面保持不变。前端做了三处改动。
我为管理员创建了一个索引管理页面。您可以查看每篇文章的索引状态并执行重新索引操作。
我将搜索栏文本更改为“自然语言搜索(最多 100 个字符)”,并在搜索结果中添加了“向量 + 关键词混合”指南。
我将搜索词限制在100个字符以内。
即使身有残疾,搜索功能也能正常使用。
免费云服务可能会变慢、停止或中断。因此,我们设计的搜索 API 确保在任何情况下都不会产生服务器错误(5xx) 。
如果无法使用 Weaviate,请改用关键词搜索。
要求 | 韦维特州 | 结果 |
|---|---|---|
首页 | 故障,超过 2 秒,超过今日使用次数 | 显示关键词搜索结果的第一页。 |
首页 | 正常,但无结果 | 显示关键词搜索结果的第一页。 |
下一页(已缓存) | 没关系 | 继续从缓存显示 |
下一页,无缓存 | 普通的 | 再次搜索,并首先显示相同的位置。 |
下一页,无缓存 | 失败 | 列表到此结束。 |
努力克服低配置服务器/免费限制
搜索仅等待 2 秒钟。如果超过这个时间,它会立即切换到关键词搜索,并且不会再次尝试。
如果连接断开,程序会暂停运行。暂停时间从 30 秒到最多 6 小时不等,之后不会重新连接。这样可以避免集群进入休眠状态时所有请求等待 2 秒。执行重新索引操作后,程序会立即重新连接。
我们只会再次尝试第一次调用。服务器刚启动时,由于设置时间,第一次 gRPC 调用很可能超过 2 秒。因此,只有在结果相同的情况下,我们才会再次尝试写入操作。
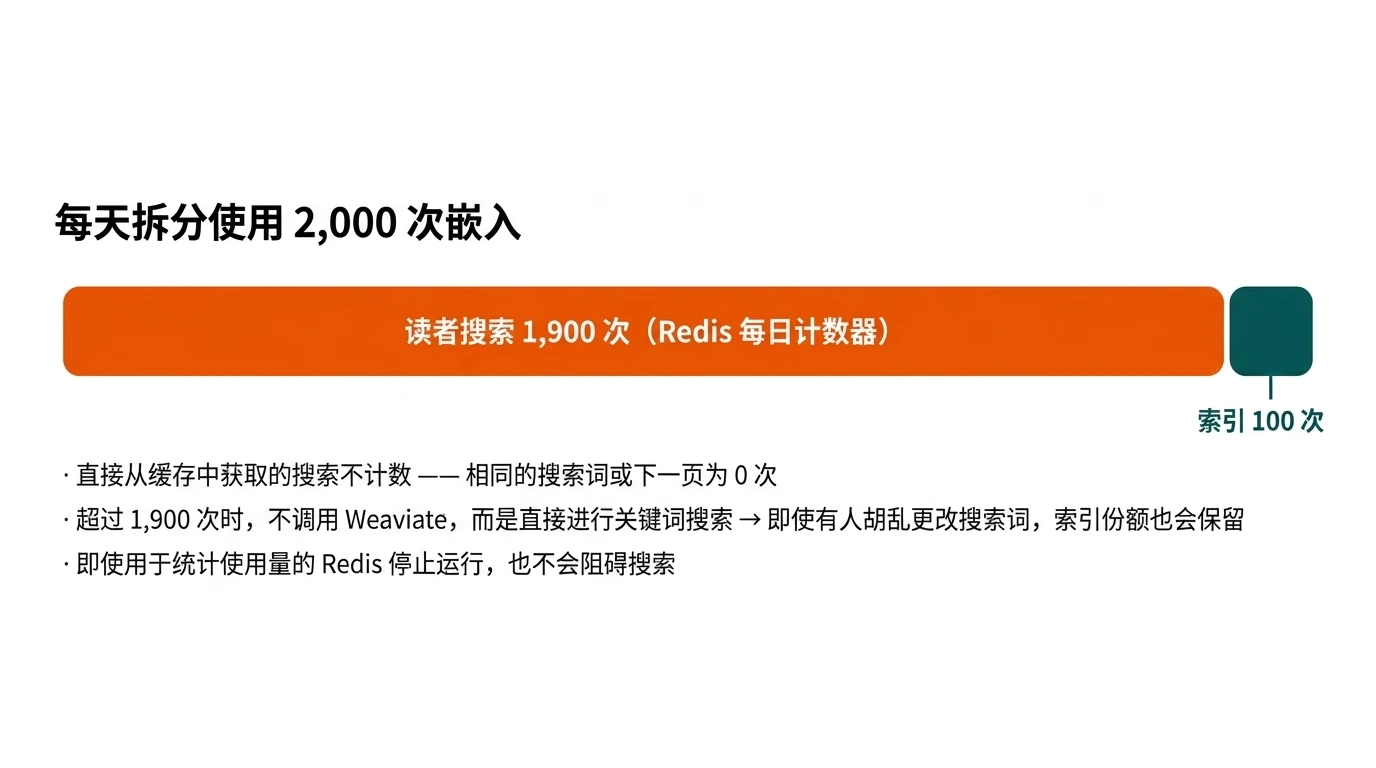
我们共享每日使用量限制。任何人都可以调用搜索 API。如果有人不断更改搜索词,每日嵌入次数就会耗尽,索引也会停止。因此,我们将每日搜索次数限制为 1900 次,其中 100 次用于索引。直接从缓存中找到的搜索不计入在内。如果用于统计使用量的 Redis 组件停止工作,搜索不会被阻止,而是照常进行。
我每天都会唤醒集群。为了避免触发“7 天不活动后停止运行”的规则,我每天清晨都会发送一个唤醒信号。但是,我还没有确认这个信号是否真的能阻止集群关闭。
你可以用开关打开和关闭它。
综上所述
在学习过程中,我了解了什么是向量嵌入、如何找到它们,以及如何调整和验证参数以提高搜索性能。基于我使用人工智能的经验,添加向量搜索功能并不难实现。然而,我对它在实际使用中的满意度还不太确定。当然,它确实能搜索到更多结果,并且显示一些看起来真正相关的内容。