
目次 (10)
- [ブログ紹介] AWS Lightsail => GCPエコシステムに移動
- 既存構造:サーバー1台に全部追い込むとできること
- 変更された構造:役割の分離と管理の切り替え
- 証明書管理から手を離す:Nginx + Certbotの代わりにCaddy
- オペレーティングサーバーからビルドを削除する:JenkinsからGitHub Actionsへ
- なぜMySQLからPostgreSQLに置き換えたのですか?
- 無中断にサーバーを変更する(Get Methodだけを生かして…)
- ドキドキ取締役後のパフォーマンス測定
- ドキドキ取締役後の費用測定(費用7500ウォンダーツですねㅜㅜ)
- 良い点、惜しい点、これから変える予定のもの、仕上げ
[ブログ紹介] AWS Lightsail => GCPエコシステムに移動
この記事は[40%本人/ 60%AI]くらいで書いています。
ブログのバックエンド( api.yooncarrot.com )をAWS LightsailからGCPに移動しました。
おもしろいUltraプランのサブスクリプションで受け取る$ 100クレジットを効率的に使用するためです。李王移転は私の判断通りに好きなように移してみました。
SpringサーバーからMySQL、Redis、Nginx、Certbot、Jenkinsまで、すべてサーバー一台に浮いていました。
これを心臓だと思うDBをサーバーから分離し、JenkinsはGit Actionsでビルドするようにしました。
よく戻ってきたサーバーをなぜあえて切り直したのか、DBエンジンまで変えながら、どのようにデータを一つも失わずに移したのか、そして引越し後の速度とコストがどのように変わったかをまとめてみました。
引っ越しながら一番気にしたのは3つです。
アプリサーバーが丸ごと飛んでいても文章が収められたDBは生き残るものも分離すること(非常に重要!!!)
無中断でサーバーを交換する
予算を効率的に使用し、パフォーマンス測定でステータスを確認する
既存構造:サーバー1台に全部追い込むとできること
フロントエンド ( yooncarrot.com ) は Vercel に置き、バックエンド ( api.yooncarrot.com ) は 2 vCPU・4GB メモリ仕様の AWS Lightsail サーバー 1 台がすべての役割を果たす仕組みでした。
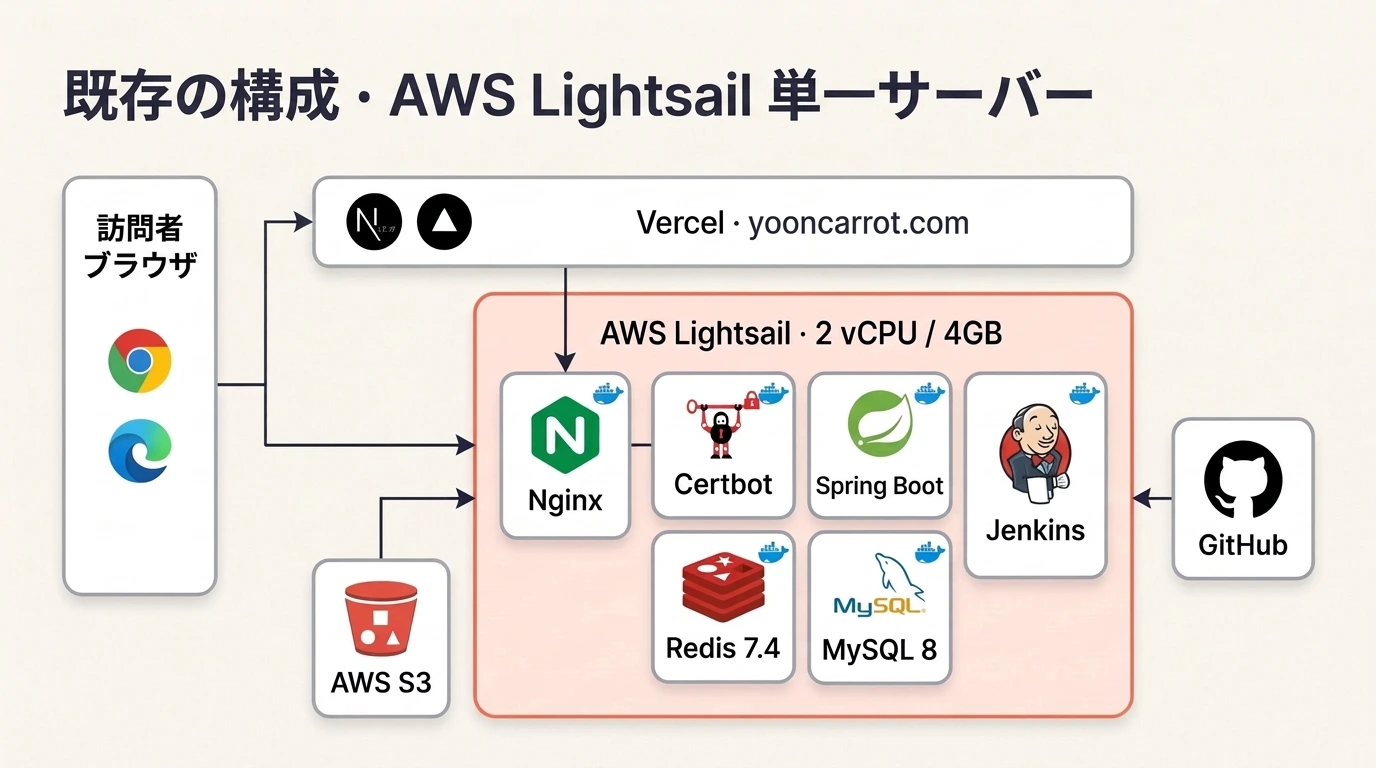
月に3万ウォン台半ばなら全部解決されるので安くて楽だったが、いつも不安な点がありました。
最大の不安は、ブログの本体であるDBがアプリサーバーと運命を共にするという点でした。ディスクが壊れるように大きな障害が発生した場合、バックアップを別に取り残さない限り、文がすべて消える構造でした。
そしてホストに直接インストールしておいたJenkinsビルドが不安を育てました。ビルドが回るたびにサーバーメモリを大きく使って残ったメモリが500MB以下に落ちました。ビルド 一度間違って回したとメモリ不足(OOM)で特定のアプリが死んだり、サーバーが遅くなることがありました。
それで、DBと重いビルドをアプリサーバーから完全に取り外すことが重要な課題だと思いました。
変更された構造:役割の分離と管理の切り替え
フロントエンドはそのままにして、バックエンドとイメージストア、DBをGCPに移しました。
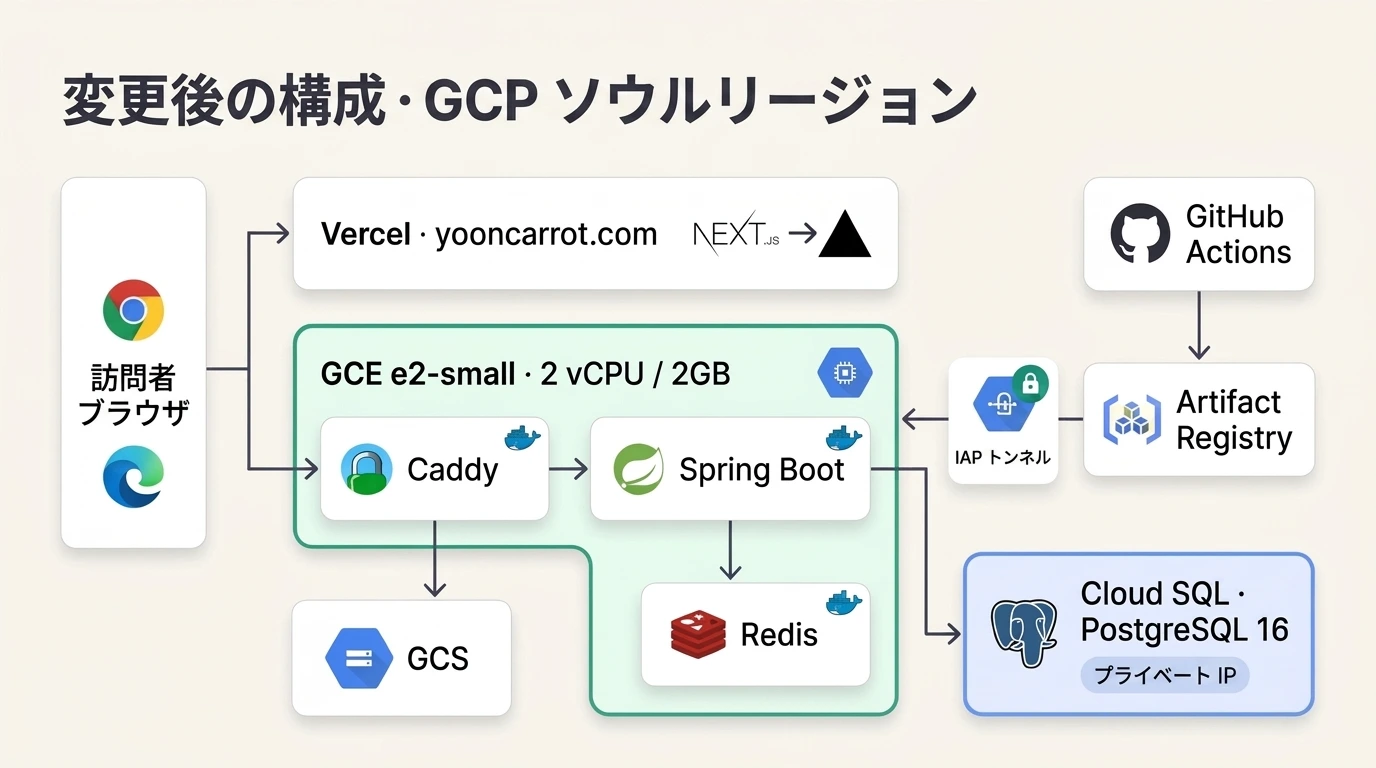
トラフィックとデータがフローの下に変わりました。
リクエストエントリとプロキシ:訪問者がリクエストを送信すると、GCE e2-smallの前面にあるCaddyが最初に受け取ります。静的イメージパス(/static/*)はGCSバケットに直接接続し、残りのAPIリクエストだけを後のSpring Bootコンテナに渡します。
DB完全分離:データを読み書きするときは、サーバー内部ではなくPrivate IPでのみ接続されたCloud SQL(PostgreSQL 16)と通信します。毎日自動バックアップを残し、7日目の時点復旧(PITR)もオンにしました。
リラックスしたメモリ:アプリサーバーのメモリは4GBから2GBに半分減りました。それでも重いMySQLとJenkinsが抜けているので、今コンテナ3個(Caddy、Spring Boot、Redis)が使うメモリはすべて合わせても500MB程度であることを確認しました。
区分 | 既存(AWS) | 変更後(GCPソウル) |
アプリサーバー | Lightsail 2 vCPU、4GB | GCE e2-small 2 vCPU、2GB |
データベース | 内部 MySQL 8 コンテナ | Cloud SQL PostgreSQL 16 |
DBバックアップ | 直接手動管理 | 自動バックアップ+ 7日PITR |
イメージストア | S3(Nginxプロキシ) | GCS (Caddy プロキシ) |
プロキシとSSL | Nginx + Certbot (自動発行/更新直接設定) | Caddy (自動発行・更新) |
ビルドとデプロイ | 内部 Jenkins ビルド | GitHub Actions 外部ビルド |
サーバー接続 | SSH 22番ポート公開 | IAPトンネルのみ(22回ブロック) |
証明書管理から手を離す:Nginx + Certbotの代わりにCaddy
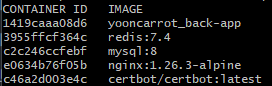
以前はNginxコンテナとCertbotコンテナを別々に浮かべ、証明書発行・更新スクリプトを直接設定しました。今回はCaddyを使ってこんな面倒をなくしてしまいました。
# 간단한 Caddy 설정!!api.yooncarrot.com { encode zstd gzip handle_path /static/* { # 이미지 → GCS 서울 버킷 rewrite * /{버킷이름}{uri} reverse_proxy https://storage.googleapis.com { header_down Cache-Control "public, max-age=2592000" } } handle { # 나머지 → Spring reverse_proxy app:9004 { header_up X-Real-IP {remote_host} } }}そして、後で無中断で配布したときに問題が発生しました。
Let's Encrypt証明書は、ドメインが実際に新しいサーバーを指す必要があります。そのため、DNSの移行前は、Caddyで事前にLet's Encrypt証明書を発行することができませんでした。そのため、GabiaでDNSをGCPサーバーに接続し、12秒ほどは証明書を発行するので、実際にバックエンドは中断になりました。
次に、バックエンド証明書をあらかじめ移しておかなければならないという考えをしました。そして、その証明書をそのまま使用しながら新たに発行されることを要すれば良いと思います。
オペレーティングサーバーからビルドを削除する:JenkinsからGitHub Actionsへ
以前の配布方式は、運用環境変数ファイルをGPGで暗号化してGitリポジトリに載せておき、コードがプッシュされるとLightsailサーバー内に浮かぶJenkinsがウェブフックを受け、サーバー内部で復号化とドッカービルドを直接回す仕組みでした。
4GBサーバーの中から重いGradle・Dockerビルドまで一緒に振り返って配布するたびにメモリー使用量が急増し、メモリーも手間がかかりました。だから今回は、このビルドと復号化過程をすべてGitHub Actionsに取り出しました。 Jenkinsで実際に得る利点はほとんどないと思いました。 (使用者も少なく、その程度で無中断配布される理由があるか、あえて?)
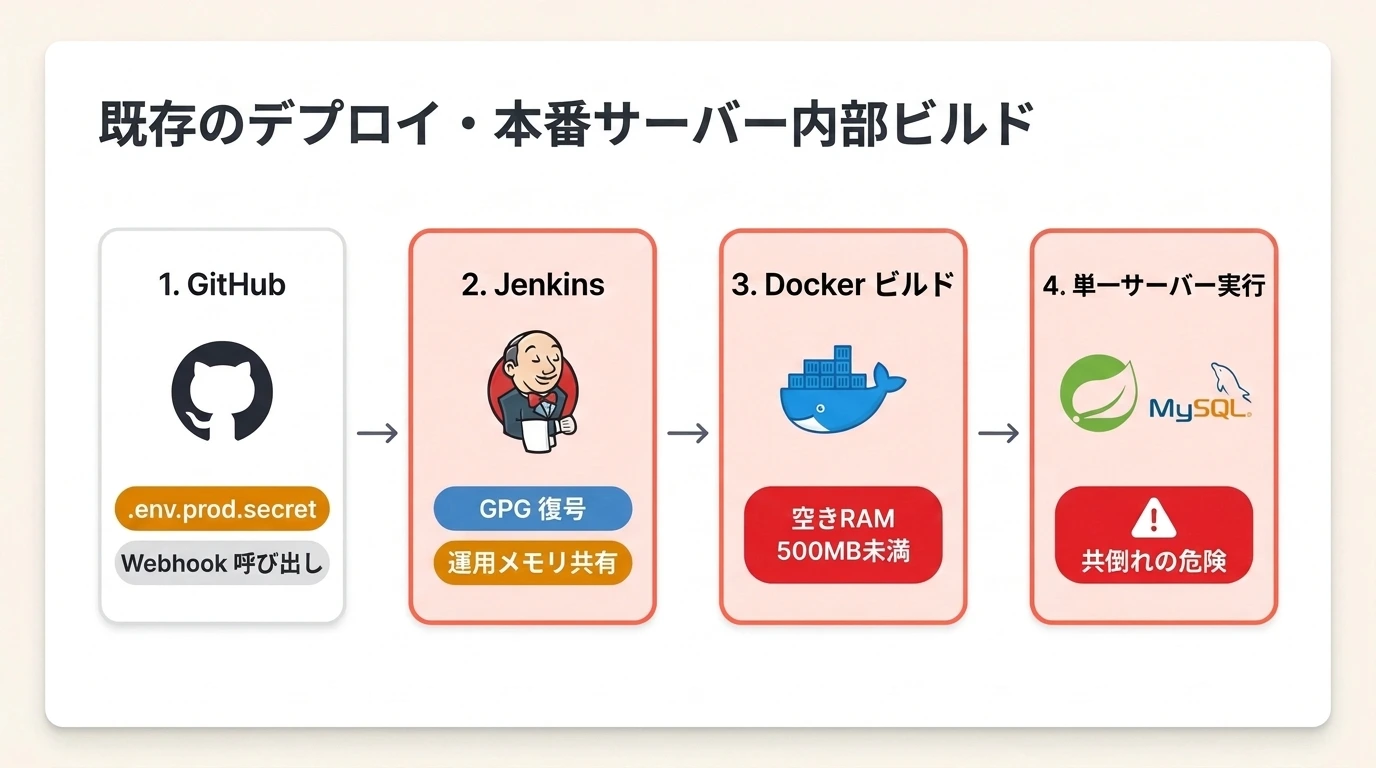
だから今回はできるだけ無料のリソースを使って外部で解決してみました。それはGithub Actionです。
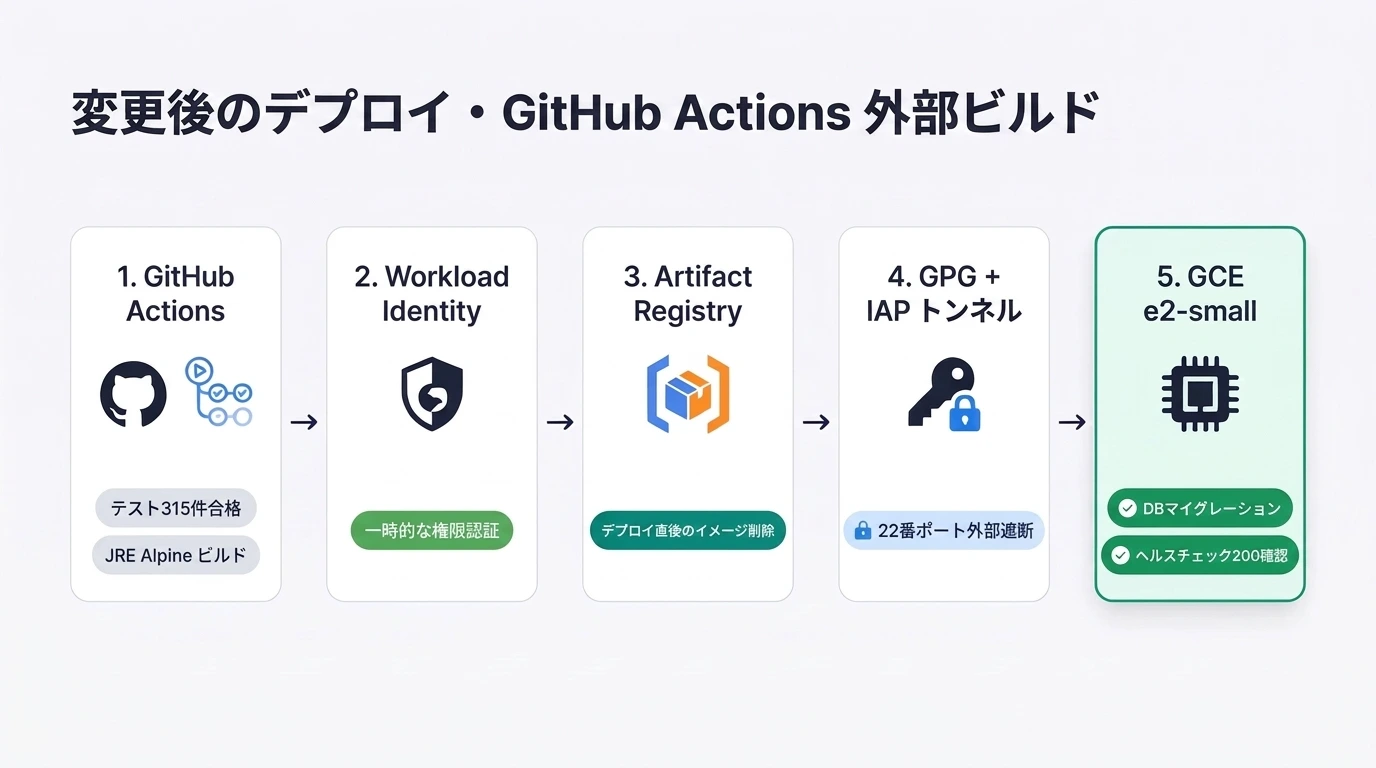
PRやdevelopブランチではテストだけを回し、mainブランチにコードが合わされたときだけデプロイが戻るようにしました。メインブランチからテストに合格したら、ドッカーイメージにしてArtifact Registryにアップロードし、.env.prod.secretファイルを復号化してIAPトンネルとしてサーバーに渡します。
そしてサーバーはDBの移行、コンテナの交換、ヘルスチェックまで終わります。
パイプラインを新しく組み込んで取り上げた利点は3つです。
サーバー負荷ゼロとアーカイブ 0ウォン: 運用サーバーは完成したイメージを受け取り実行だけです。イメージを受け取るやいなや成功・失敗にかかわらず、レジストリから直ちに消去し、1日の自動削除ポリシーまで重ねて掛けてレジストリコストが$0です。
キーファイルなし認証:GCPサービスアカウントJSONキーをGitHubに保存しないでください。 Workload Identity Federationは、このリポジトリのワークフローのみをデプロイする瞬間に一時的な権限を取得し、アプリサーバー自体にはイメージの受信とログの書き込み権限だけを残しました。
22番ポートの完全ブロック:セキュリティが悪い22番ポートのインバウンド/アウトバウンドを排除し、Google IAPトンネルでのみサーバーに入るのを防ぎました。
なぜMySQLからPostgreSQLに置き換えたのですか?
今回の取締役で一番ボールが多い作業です。単にサーバーからDBを取り出すのにとどまらず、エンジンをMySQL 8からPostgreSQL 16に置き換えました。 Cloud SQL は一度作成すると、後でエンジンを変更することができず、初めて作成するときにうまく作成する必要がありました。
PostgreSQLを選んだのは2つのためです。
今、自然言語検索のために浮かんだWeaviateを後でpgvectorに合わせて、いつでもインフラストラクチャを置き換えることができます。
ハングル部分検索に有利なpg_trgmを直接書くことができる。 (mysqlではngramを使用)
そして、MySQLとPostgreSQlでテーブル列のデータ型が違うものを合わせてくれるのに時間を費やしました。
変換項目 | MySQL 8 | PostgreSQL 16 |
ユーザーID | バイナリ(16) | uuid |
フラグ列 | tinyint | boolean |
JSONデータ | json | jsonb |
自動増分キー | AUTO_INCREMENT | GENERATED BY DEFAULT AS IDENTITY |
修正時刻の更新 | ON UPDATE CURRENT_TIMESTAMP | BEFORE UPDATEトリガー |
ハングル検索 | FULLTEXT(MATCH...AGAINST) | pg_trgm GIN + ILIKE |
配列の集計 | JSON_ARRAYAGG | json_agg |
無中断にサーバーを変更する(Get Methodだけを生かして…)
引っ越しの途中で誰がコメントやいいねを残すと、古いサーバーだけに残って蒸発する問題も防げなければなりませんでした。だから書き込みは開いたままにして書き込みだけしばらく停止するようにしておいて、GCPにサーバーを移動しました。
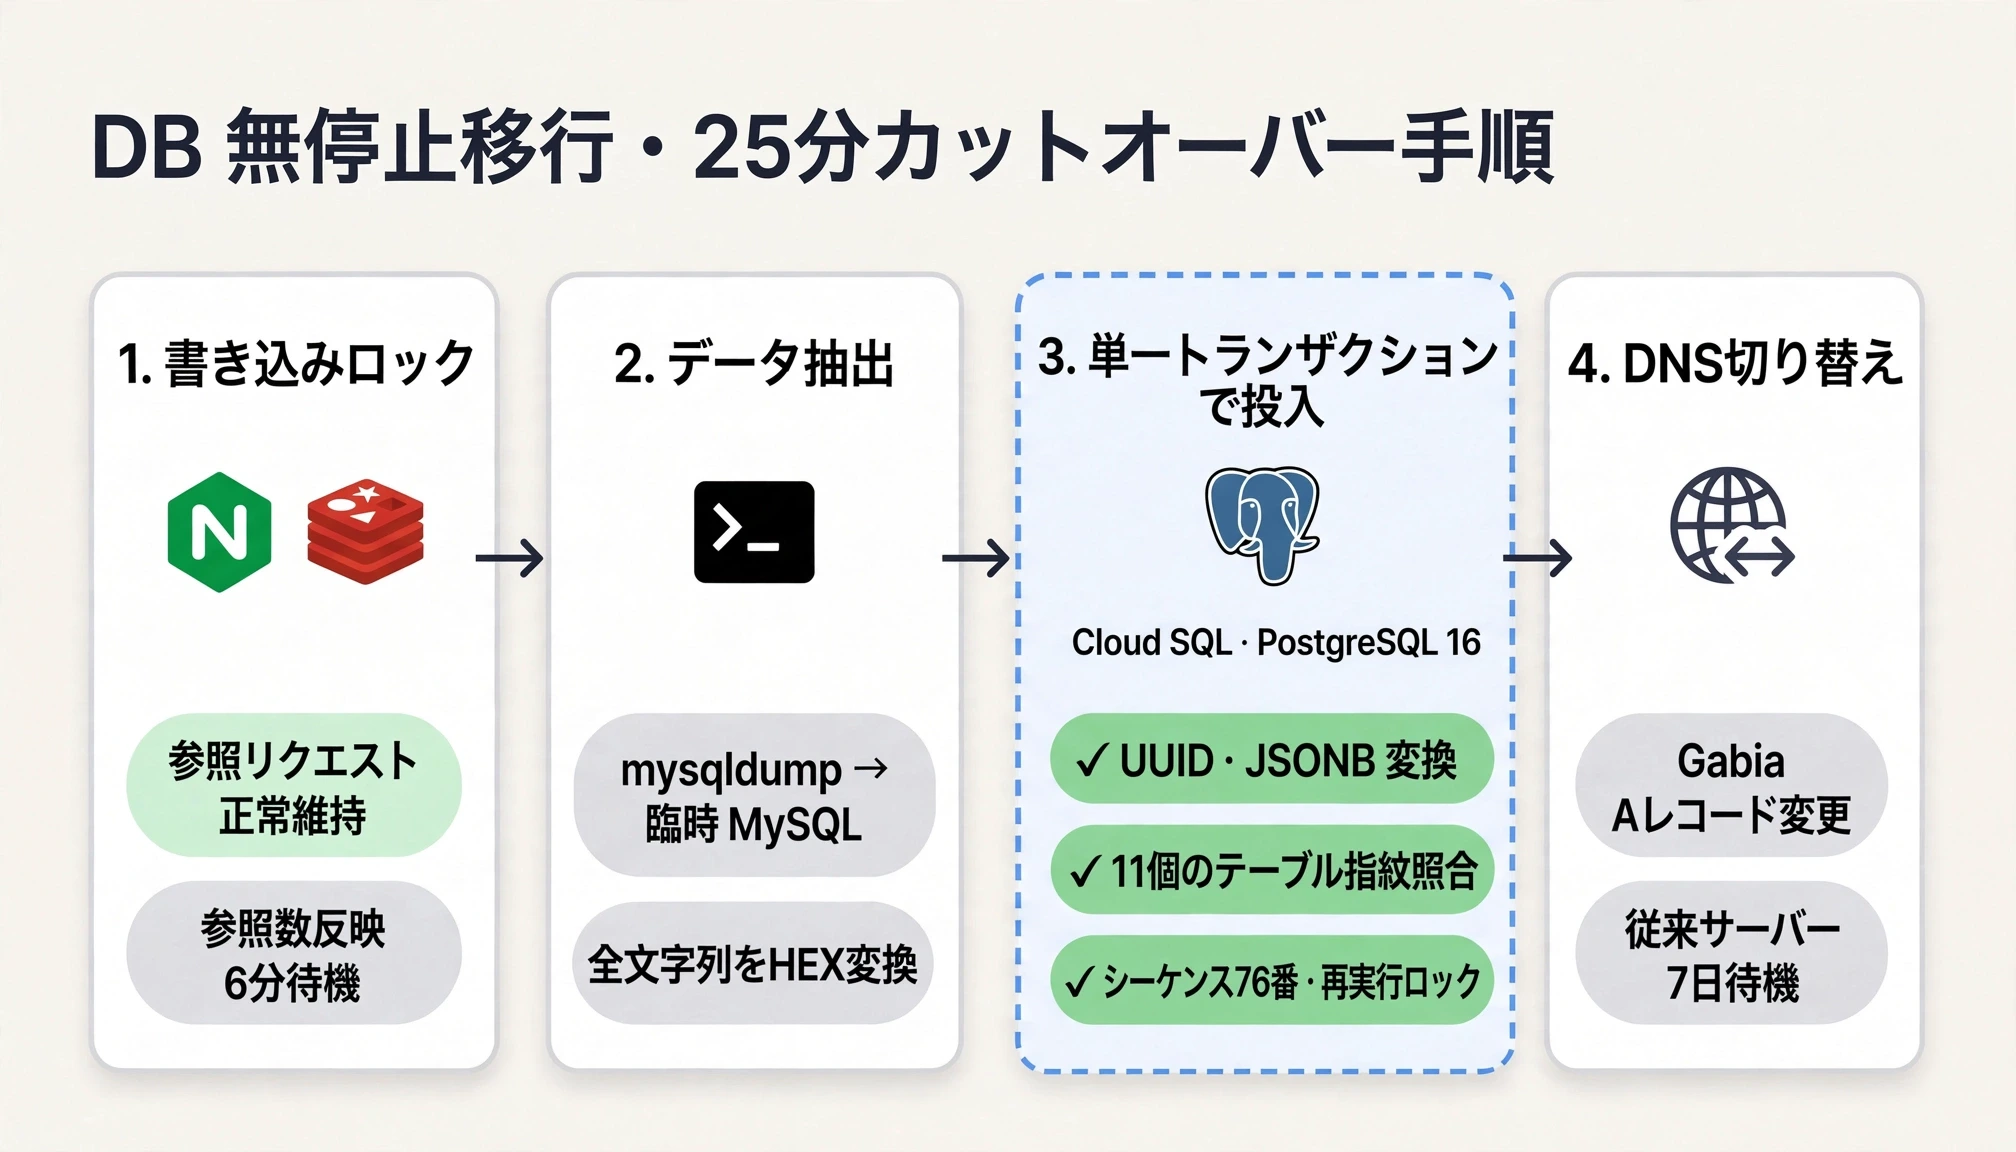
引越し当日は以下の順に行いました。
書き込みブロックと6分待機:まだDNSが古いサーバーを見つめた状態でGCPアプリを最初に停止しておき、古いサーバーNginxでGET以外のリクエストは503にブロックしました。記事の読みはいつものようになりますが、コメント・いいね・照会数の記録だけが止まる状態です。ヒット数はRedisに集まって5分ごとにDBに反映されるので、残りのヒット数がMySQLに入るまで6分待ちました。
HEXエンコーディング抽出:mysqldumpに浮かんだデータをGCPサーバーの一時MySQLコンテナ(メモリ512MB制限)に復元した後、本文のタブ、改行、バックスラッシュ、絵文字がコピー中に壊れないように、すべての文字列をHEXに置き換えてPostgreSQL一時スキーマに渡しました。
単一トランザクション変換とクロス検証:トランザクション一つの中でUUID・ブルリオン・JSONB変換積載、次の投稿番号列のリセット、元との行数比較を一度にまとめました。途中で一つでもずれると全部ロールバックされ、Cloud SQLは触れないまま残しました。
積載前は、コードにない列が運用DBだけに静かに発生することがないように列リストから対照し、終了後には11個のテーブルの行数とキー指紋、画像容量まで元と比較しました。再実行ロックとDNS切り替え:同じトランザクションの最後に完了マーカーまで一緒に記録しておき、DNS切り替え後に誤ってエスカレーションスクリプトを再実行しても、マーカーを確認してすぐに停止して新しいデータを上書きするのを防ぎました。検証が完了した直後にGCPアプリを起動し、GabbiaのAレコードを新しいIPに置き換えました。
執筆が詰まっていた時間は約25分で、その間にも訪問者は絶えず文を読むことができました。もし問題が生じたらAレコードだけを返せば良いように、既存のサーバーは7日間そのまま待機させておきました。
ドキドキ取締役後のパフォーマンス測定
読み取り専用で生きているLightsailサーバーと新しいGCPサーバーに韓国PCで毎回新しい接続を結び、同じリクエストを交互に100回ずつ送って応答時間を見直しました。 (10000回ずつもできますが、まさに運用サーバーとはなりませんでした。)
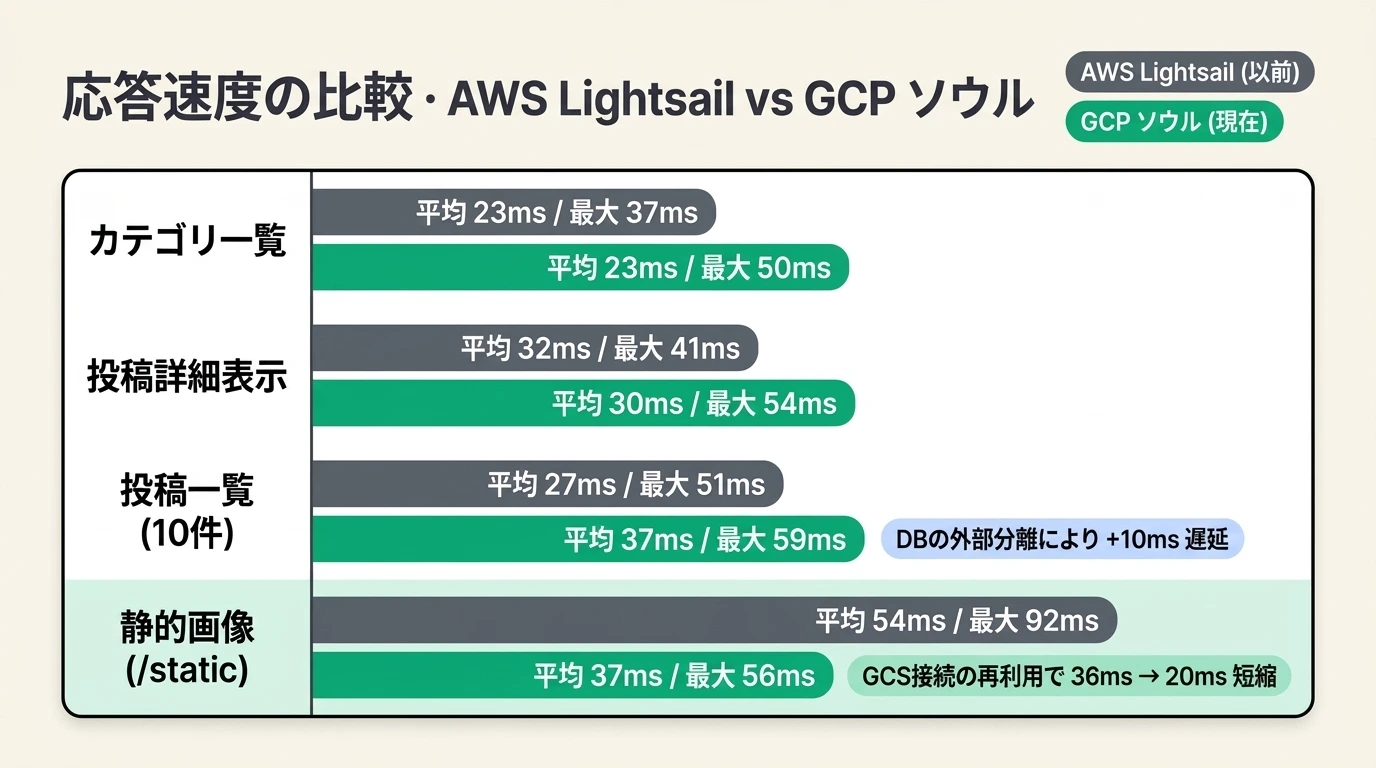
リクエストの種類 | ライトセール(p50/p95/p99) | GCPソウル(p50/p95/p99) |
カテゴリ一覧 | 23/26/37ms | 23/25/50ms |
投稿リスト(10) | 27/39/51ms | 37/52/59ms |
投稿詳細検索 | 32/37/41ms | 30/36/54ms |
ハングル検索 | 26/35/46ms | 31/36/139ms |
イメージ(/static) | 54/85/92ms | 37/41/56ms |
測定してみるとある程度傾向が見えました。 (リクエスト100番のうちp99は最も遅い1~2番に左右されるので全体の傾向だけをご覧ください。)
最も嬉しいのは、画像の応答速度がp50基準54msから37msに、p99基準92msから56msに拡がったということです。
なぜか調べてみると、もともと使っていたS3もソウルリージョンだったが、以前Nginx設定はS3アドレスを変数に渡すのにupstreamとして登録されていない(proxy_pass https://$bucket )、接続を再利用できず、毎回新しく結ぶことが頻繁でした。 CaddyがGCSとの接続を再利用し、同じリージョンのGoogle社内ネットワークに乗り込み、サーバー内部の処理時間だけが36msから20msに短縮されました。
一方、記事リストの照会や他のAPIのP99が10msほど遅くなったのはDBを外して引き出していると思います。同じサーバー内のコンテナ同士で通信していた以前とは異なり、ネットワーク越しのCloud SQLに行くからだと思います。そして、検索はヨーロッパでWeaviateを呼び出すときに起こり、たくさん飛び出すと思います。
ドキドキ取締役後の費用測定(費用7500ウォンダーツですねㅜㅜ)
既存のLightsailは税込実際の請求額が月$27.01(約36,500ウォン)です。
移転後、GCPソウルリージョンの月額費用は税引前$29.60 、付加税10%を含めると約44,000ウォンであると予想します。
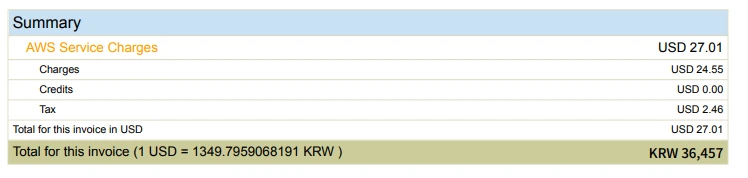
今は既存と現在の料金を比較してみましょう。そしてGCEは1年約定すれば割引をしてくれてそれも含めて追加選択肢として追加してみました。
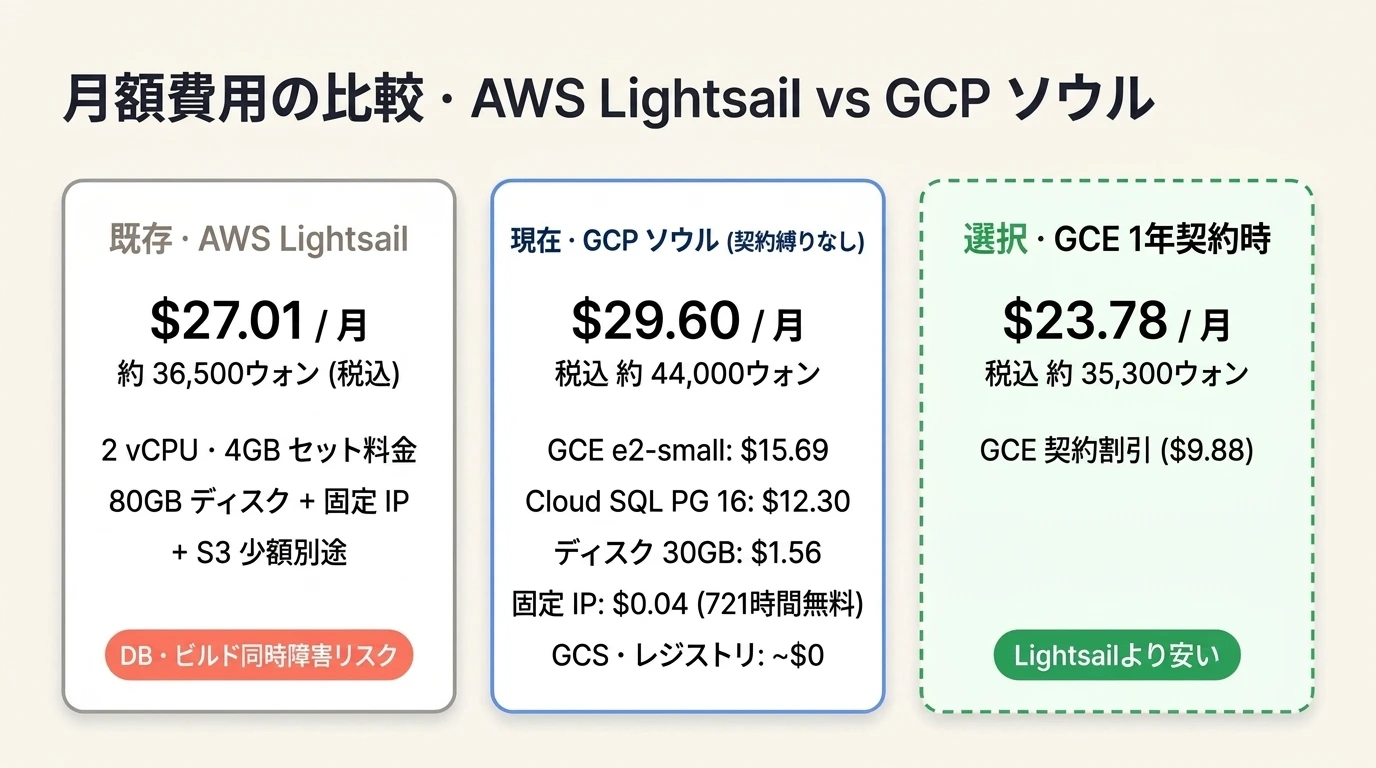
月に約7,500ウォンだけ出して
サーバが丸ごと飛んでも文が保存される自動バックアップ・視点復旧環境
DBを分離して拡張性と高可用性(HA)を得ました。特にDBが心臓なのにこれをより安全に守ることができてよかったです。
Google AI Ultraサブスクリプションが提供するGCPクレジットで無料でサーバーを維持できます。
上記のような効果をさらに得ましたね。今、サーバーが飛び出してブログDBまで爆発する心配はなくなって、伸びて寝ることができます。 Z2z ...
良い点、惜しい点、これから変える予定のもの、仕上げ
良い点
今回の取締役でアプリサーバーは状態をほとんど持たないランチャーになりました。サーバーが壊れても新しいインスタンスを浮かべて、デプロイだけを再度回すと回復が終わり、後でトラフィックが増えればサーバーの体重だけを上げればいいという拡張性ができました。
残念な点
GCPエコシステムでは、AWSと同じくらいのコストでサーバーを運営するのは難しいです。当初、Lightsailは低コストのクラウドサービスをターゲットにしたサービスなので、コストパフォーマンスが良いですが、GCPでは低価格のクラウドサービスをターゲットにしていないため、同じパフォーマンスに価格が少し高価だと思います。
DBを分離しましたが、HAを広く保証しません。 HA prefixがついたDBは2倍くらい高価ですが、同じリージョンの他の地域に同じDBをコピーしておくという。それで、はるかに高可用性になってほしいのですが。実際、それほど重要なデータではありませんか?主単位のバックアップだけでも消失する量も多くなくて。
RedisはCloudで書くのに高すぎる。だからちょうどSpringサーバーと同じ場所で浮かんだ。また、リバースプロキシもGCPで提供するものを使いたかったのですが、お金がかかるようで、ただ直接Caddy(Nginx + Cert)浮かびました。
これから変える予定のもの
今GPGで.env.prodを暗号化してGitにアップロードしています。そして、ランナーがこれを復号化してサーバーの実行に書き込むことができるようにします。ところで、実際には設定ファイルをリポジトリコミットに上げること自体がリスクになる可能性があると思います。そのため、GCP Secret Managerで環境変数を分離してGitから暗号化ファイル自体を蹴る予定です。
メモリが残ったら、Blug/Green 配布を適用してみてください。
ファイルのアップロードをPresigned URLに置き換えましょう。だから、あらかじめファイルアップロードができるようにして、もしファイルアップロード確定までしないと自動的に消去される方法になるようにしようと思います。ファイルアップロード確定は、投稿が投稿される瞬間になるようにするつもりです。 (S3はpresigned、GCSはsigned URL)
今後1週間の間、特に問題なくうまくいくと、これまで苦労したLightsailサーバーとS3バケットを完全に整理しようと思います。そしてGCP料金も出たらこの記事を更新しておきます。 AI時代に幅広く理解しているので、インフラストラクチャを考えてそのまま織ることができるようなので、とても良いですね。