
目次 (13)
[풀스택 개발자 전직하기] 1편. 용어 정리
AI시대가 오면서 생산성이 극대화되고 있어요. 그리고 하나의 기능을 구현하는데 프론트, 백엔드 나눠서 하는 것도 점차 소통 낭비가 되어가는 것 같다고 생각해요. 그래서 AI 시대가 오면 Frontend, Backend, CI/CD, Infra, DB, Data, AI, 심지어는 기획부터 마케팅까지 모두 다룰 수 있어서 혼자서 A to Z를 담당할 수 있는 사람을 필요로하는 기업들이 많아질거라 생각해요. 또는 저가 창업을 하더라도 혼자서 다 할 수 있다면, AI를 직원으로 원하는 서비스는 다 만들 수 있을거라 생각해요.
저가 일을 하면서 느끼는 거지만, AI를 잘 활용하면 따라잡기 힘들고 거대해 보이는 경쟁사들의 기능들은 실력있거나 머리 좋은 개발자 1명이 모두 따라잡을 수 있다는 생각이 들어요. 지금도 저가 만든 기능들이 이미 경쟁사보다 더 뛰어나지고 있는 부분들이 계속 생기고 있는 것을 직접 보고 있고, 이 속도 그대로 유지하면 아무리 못해도 1년 안에는 다 따라잡고도 남을 거라고 직감하고 있어요.(물론 저는 약간의 실수가 큰 손해로 이어지지 않는 환경입니다! 약간의 실수가 큰 피해로 이어지는 환경이라면 많은 고민을 해야할 것 같아요. 어떻게 기능 개발도 빨리하고, 실수하는 상황 발생을 없애면서 생산성을 높일지 말이에요) 이렇게 저처럼 가능하다고 생각하는 사람들은 이미 많을거라 생각해요. 그래서 1년만 지나도 개발 이론을 깊게 아는 것이 의미가 없어질 것 같다는 위기감을 느껴요.(사실 확신해요. 2~3개월 전까지만 해도 그래도 필요하겠지.. 라고 생각 했지만 글쎄요... 물론 알고 하는거랑 모르고 하는 차이가 분명히 있을 거라곤 생각합니다만 아무튼 그렇습니다. 혼란스럽습니다~. 엉클 밥 아저씨도 이제 코드를 안 읽는다고 말하셨어요. 코드를 반드시 읽어 책임감을 다해야 한다는 말에 얼마전에 설득이 되었었는데, 실제 일하면서 코드를 반드시 모두 읽어야하는 필요성이 정말 있을까에 대해 다시 고민하게 됩니다. 테스트 코드로 영향 범위를 체크하고 부작용을 체크하고 + 인간 QA로 검증하는 방식이 더 빠르지 않을까 라는 생각을 하고 있습니다. 물론 대기업에서는 작은 프로젝트 아니면 불가능 하다고 생각하지만요.)
그래서 저는 누군가에게 전자기기를 통해 어떤 기능 제공을 위해 필요한 A to Z를 할 수 있는 개발자가 되기 위해 백엔드 파이프라인을 공부하고자 해요.
들어봤던 백엔드 기술들 총집합 (파이프라인으로)
들어봤던 기술들에 대해 간단하게 하나씩 설명만 해보려고 해요. 제너럴리스트가 되는 과정으로 생각하고 같이 공부해봐요. (나름 부족한 부분들 AI에게 다 채워달라고 하면서 맥시멀리스트처럼 들어보거나 아는거 또는 몰랐던 거까지 다 꾸겨 넣어봤어요.)
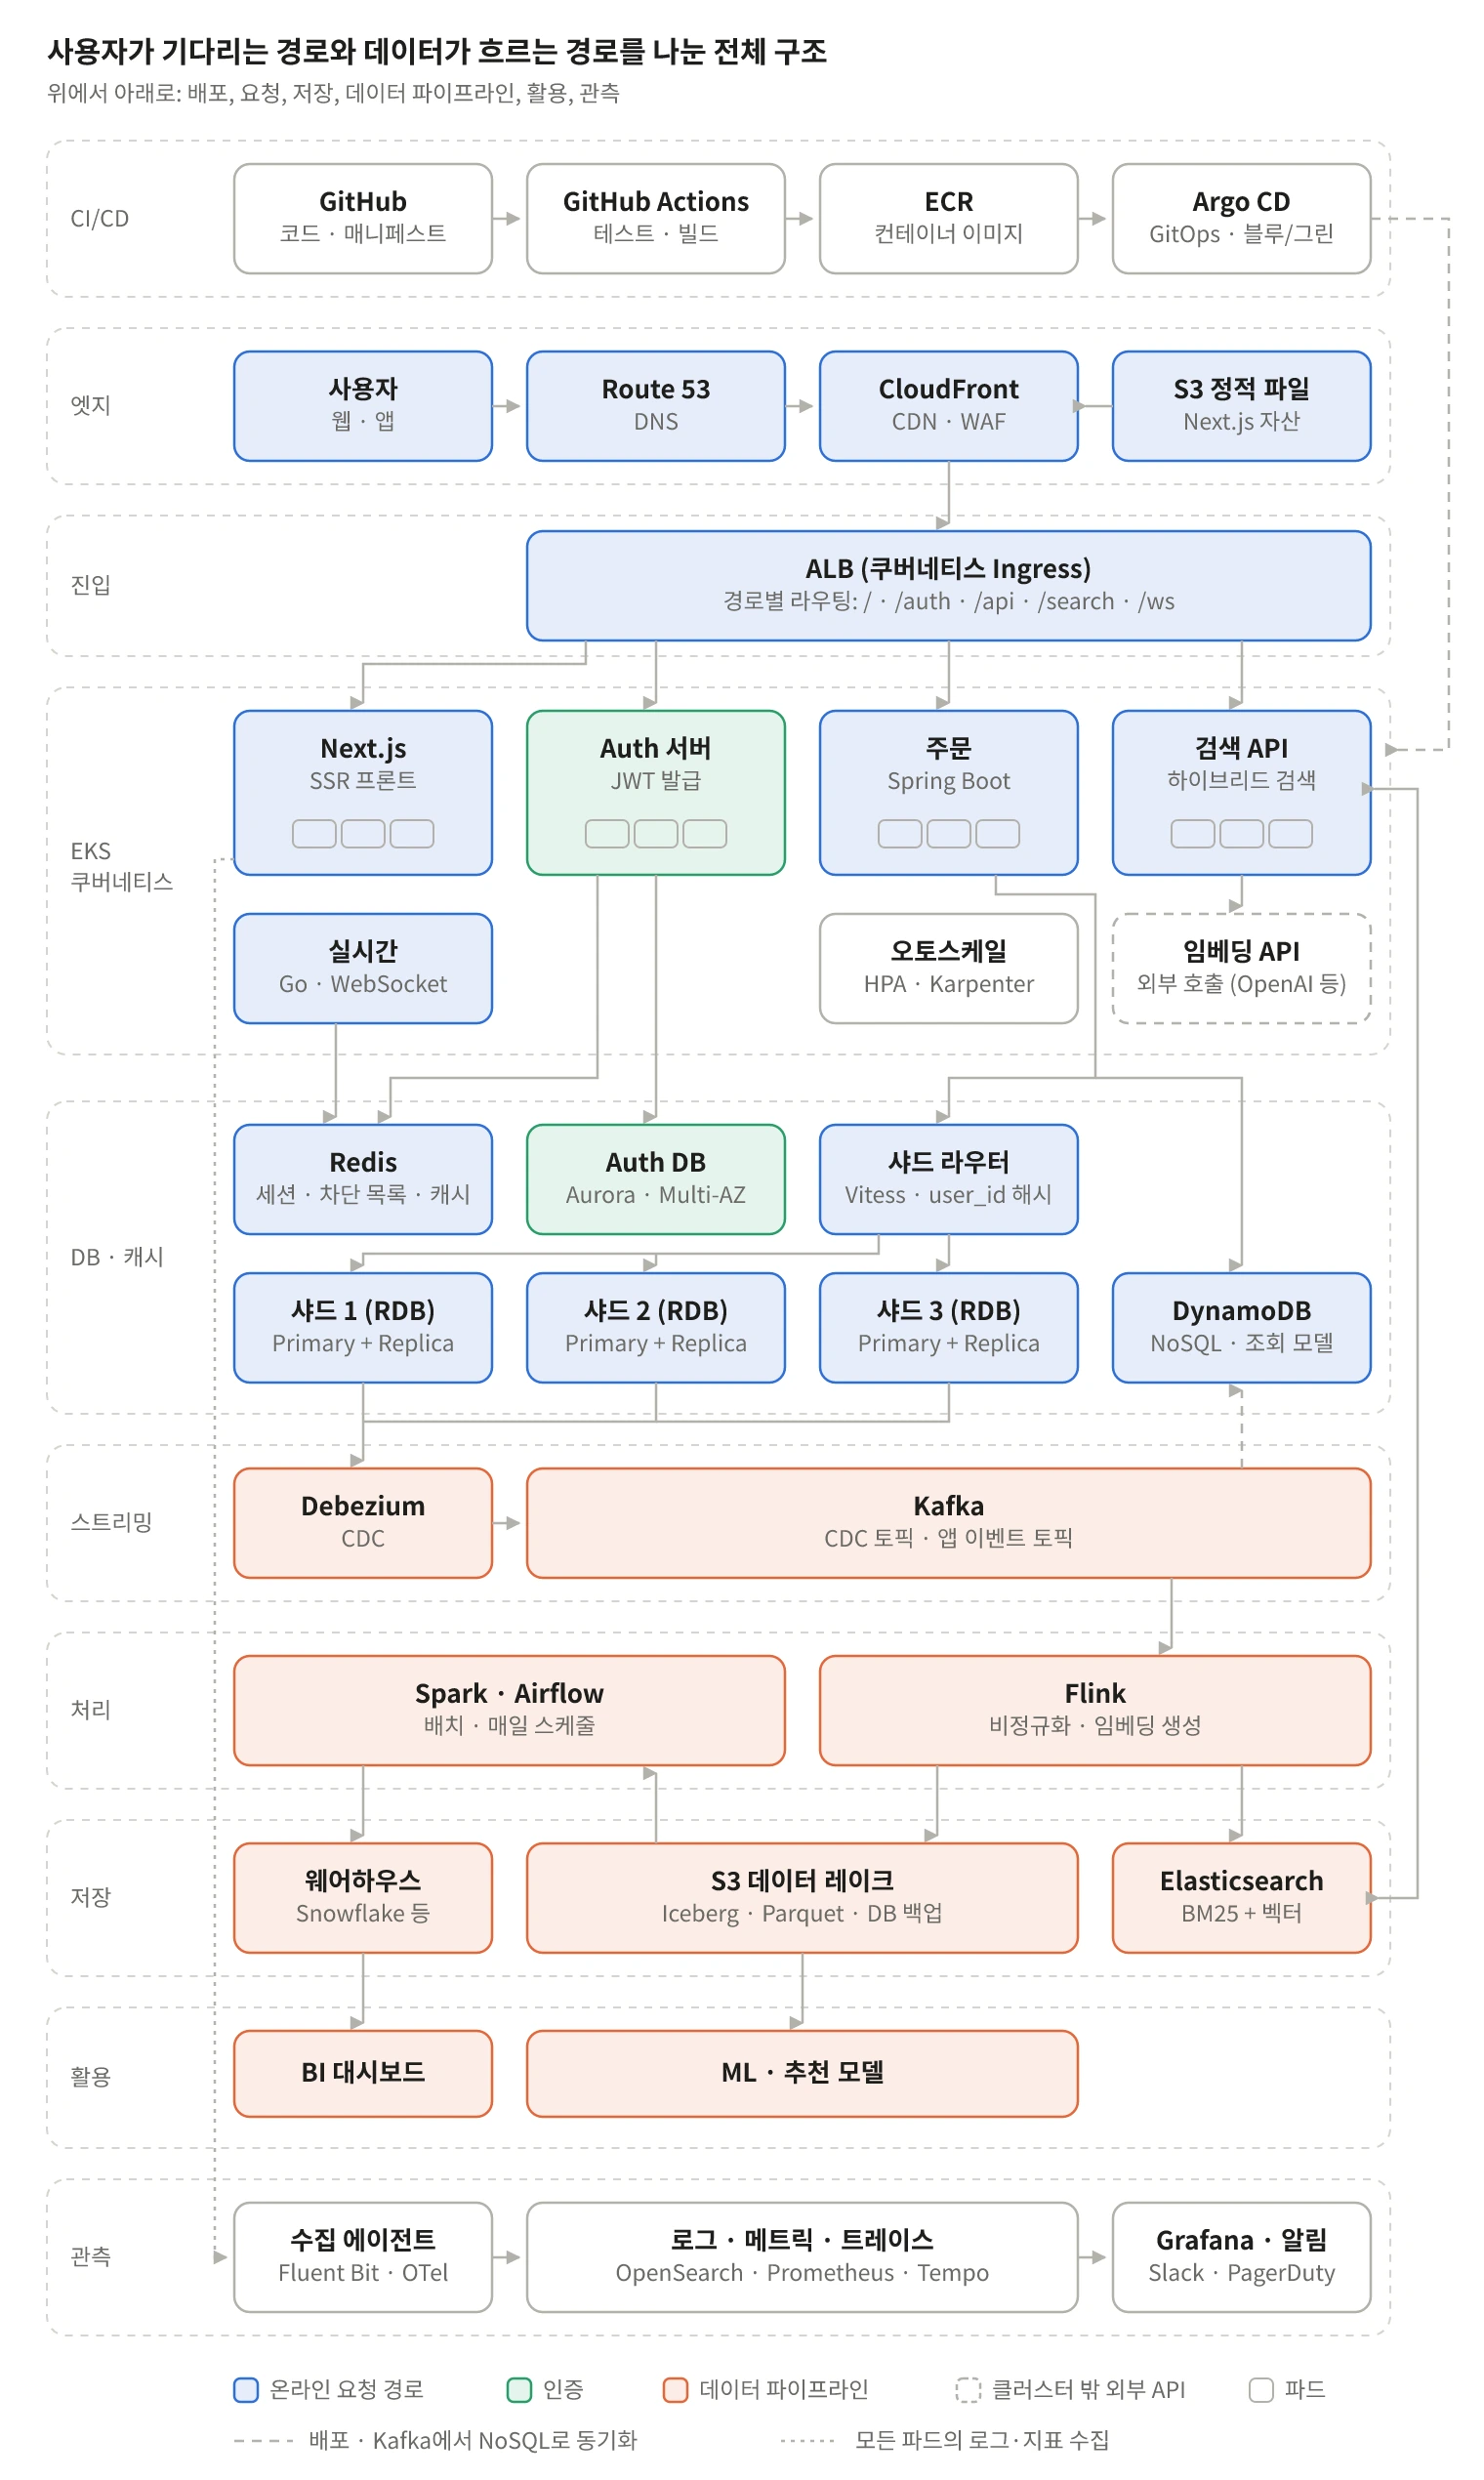
1. CI/CD: 코드가 운영 서버에 올라가기까지
CI(지속적 통합)는 코드를 합칠 때마다 자동으로 테스트하고 빌드하는 것이고, CD(지속적 배포)는 그 결과물을 자동으로 운영에 내보내는 것입니다.
용어 | 한 줄 정의 | 이 그림에서 하는 일 |
|---|---|---|
GitHub | 코드를 저장하고 리뷰하는 Git 저장소 서비스 | 앱 코드와, "운영에 어떤 버전을 띄울지" 적은 매니페스트를 보관합니다. 모든 변경은 PR(풀 리퀘스트)로 리뷰를 거쳐 들어옵니다. |
GitHub Actions | GitHub에 내장된 자동화 실행기 | 코드가 합쳐지면 테스트를 돌리고, 통과하면 도커 이미지를 빌드해 ECR에 올리고, 매니페스트의 이미지 태그를 새 버전으로 바꿉니다. |
ECR | AWS의 컨테이너 이미지 저장소(Elastic Container Registry) | 빌드된 도커 이미지를 order:v42처럼 버전 태그를 붙여 보관합니다. 쿠버네티스는 여기서 이미지를 받아 파드를 띄웁니다. 비유하면 앱 설치 파일을 모아 두는 사내 앱스토어입니다. |
Argo CD | 쿠버네티스용 GitOps 배포 도구 | 매니페스트 저장소를 계속 지켜보다가, Git에 적힌 상태와 클러스터의 실제 상태가 다르면 클러스터를 Git에 맞춥니다. 그래서 배포도 롤백도 "Git 커밋 하나"로 끝납니다. 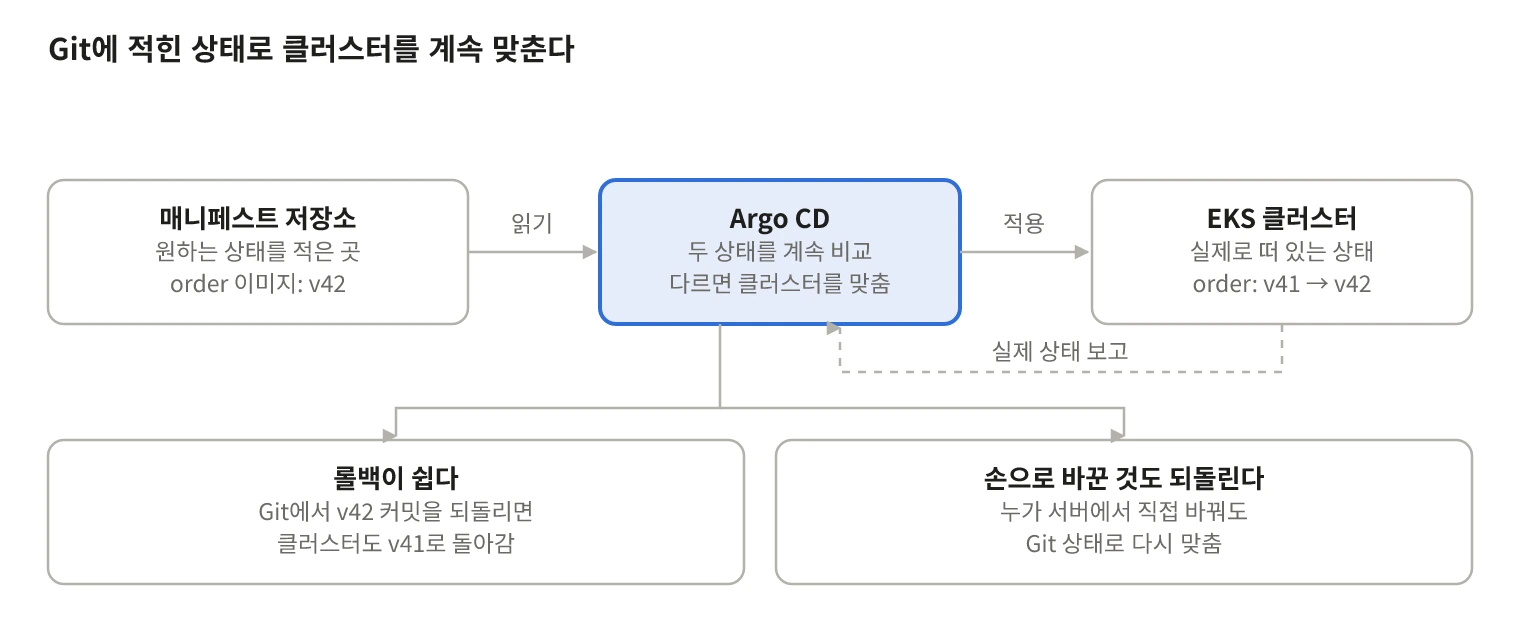 |
GitOps | Git을 운영 상태의 유일한 기준으로 삼는 방식 | 누가 언제 무엇을 배포했는지가 Git 기록에 그대로 남습니다. 서버에 직접 접속해 바꾸는 일이 없어집니다. |
블루/그린 | 새 버전을 옆에 통째로 띄운 뒤 트래픽만 옮기는 배포 방식 | 문제가 생기면 트래픽을 옛 버전(블루)으로 되돌리기만 하면 됩니다. 단계적으로 옮기면 카나리 배포라고 부릅니다. |
2. 엣지: 사용자와 가장 가까운 곳
엣지는 사용자의 요청이 우리 시스템에 처음 닿는 지점입니다. 여기서 주소를 찾아 주고, 자주 받는 파일은 가까운 곳에서 바로 돌려줍니다.
용어 | 한 줄 정의 | 이 그림에서 하는 일 |
|---|---|---|
사용자 (웹·앱) | 브라우저나 모바일 앱 | 화면을 받고, 버튼을 누를 때마다 API를 호출합니다. 로그인 후에는 JWT 토큰을 들고 요청합니다. |
Route 53 | AWS의 DNS 서비스 | shop.example.com 같은 도메인 이름을 실제 서버 주소로 바꿔 줍니다. 전화번호부 역할이고, 한 리전이 죽으면 다른 리전으로 돌리는 헬스체크도 합니다. |
CloudFront | AWS의 CDN(콘텐츠 전송 네트워크) | 전 세계 엣지 서버에 정적 파일을 복사해 두고 사용자와 가까운 곳에서 돌려줍니다. 서울 사용자는 서울 엣지에서 받으니 빠릅니다. API 요청은 캐시하지 않고 뒤의 ALB로 넘깁니다. 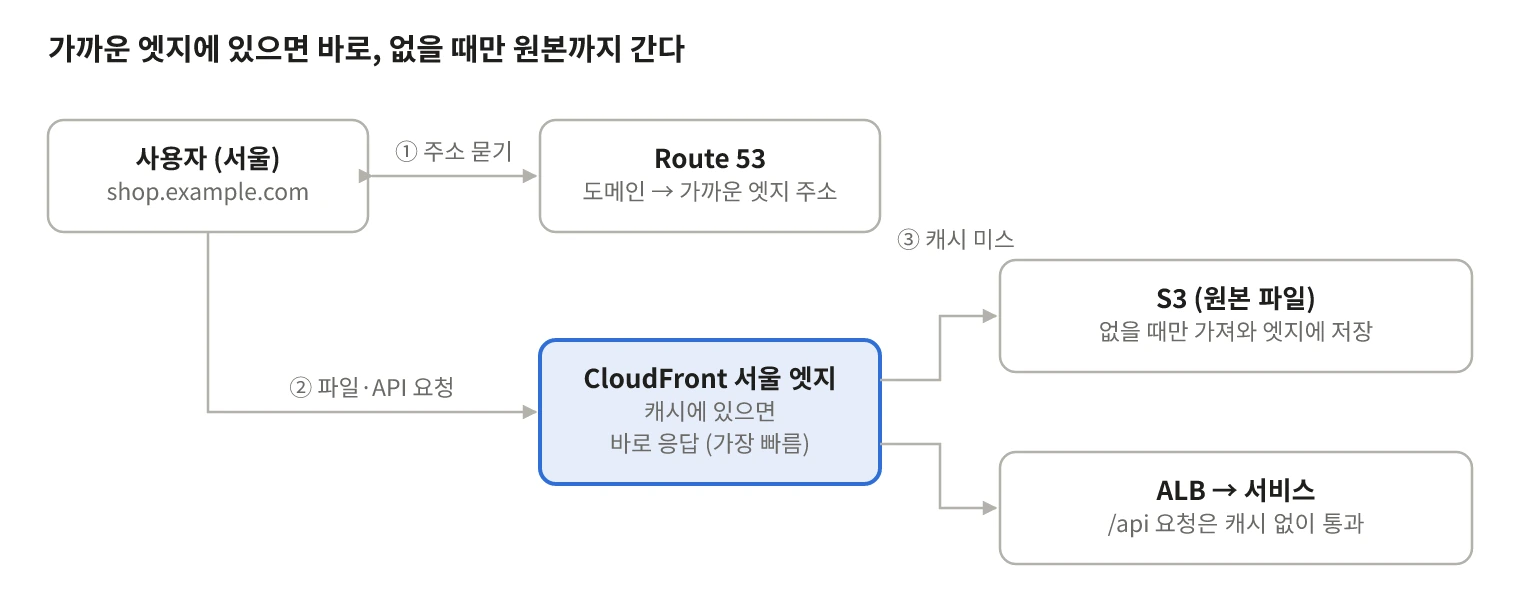 |
WAF | 웹 방화벽(Web Application Firewall) | CloudFront 앞에서 SQL 인젝션, 봇, 비정상적으로 많은 요청 같은 공격을 걸러 냅니다. |
S3 정적 파일 | AWS의 파일 저장소에 올린 프론트 빌드 결과물 | Next.js가 만든 JS, CSS, 이미지 파일을 보관합니다. 파일 이름에 버전 해시가 붙어 있어서 배포 중에도 옛 버전과 새 버전 파일이 섞이지 않습니다. |
3. 진입: 요청을 알맞은 서비스로 나누는 관문
엣지를 통과한 API 요청은 로드밸런서에서 경로를 보고 담당 서비스로 갈라집니다.
용어 | 한 줄 정의 | 이 그림에서 하는 일 |
|---|---|---|
ALB | AWS의 L7 로드밸런서(Application Load Balancer) | URL 경로를 보고 /auth는 Auth 서버로, /api는 주문 서비스로 보내고, 같은 서비스의 여러 파드에 요청을 고르게 나눕니다. 헬스체크에 실패한 파드는 자동으로 뺍니다. 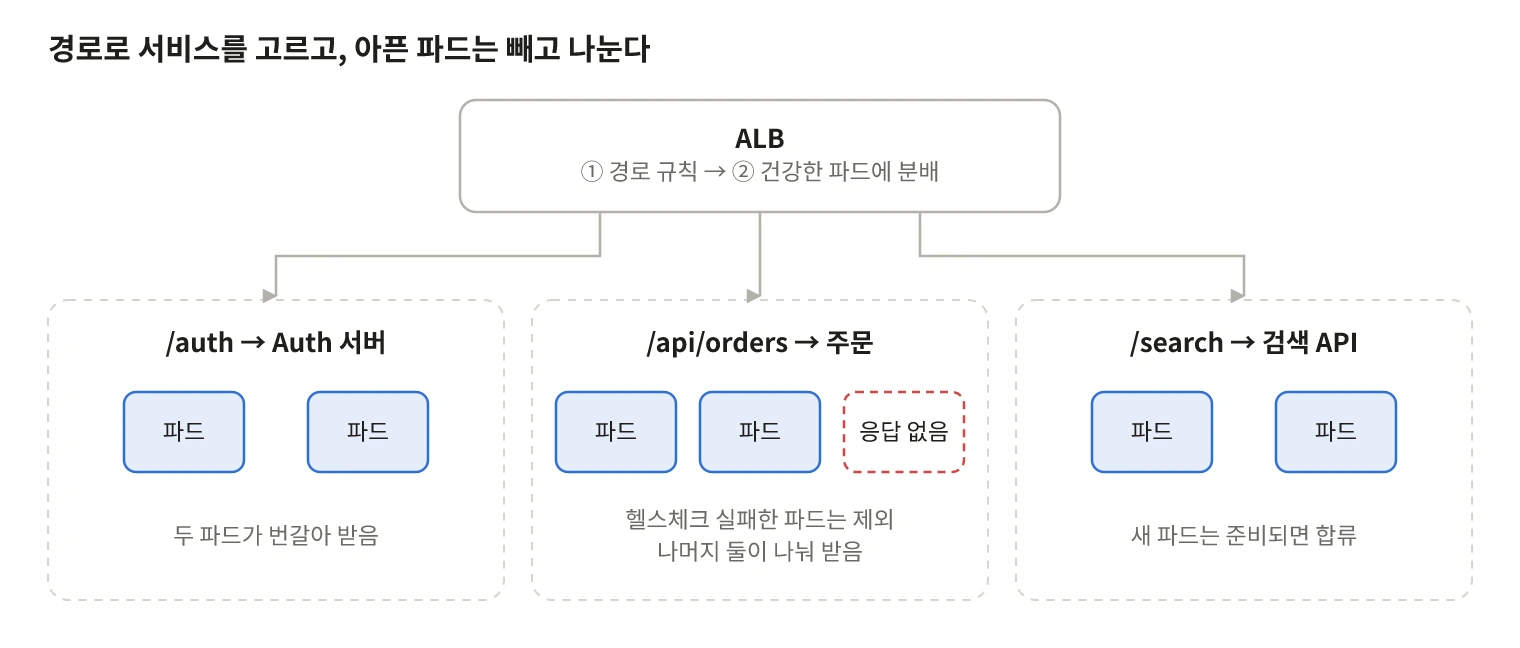 |
쿠버네티스 Ingress | 클러스터 바깥에서 들어오는 경로 규칙을 적는 쿠버네티스 리소스 | "이 경로는 이 서비스로"를 YAML로 적어 두면, AWS Load Balancer Controller가 그대로 ALB를 만들고 설정합니다. 로드밸런서 설정도 코드로 관리되는 셈입니다. |
경로별 라우팅 | 요청 주소의 경로로 목적지를 고르는 방식 | 하나의 도메인 아래에서 여러 서비스를 운영할 수 있게 해 줍니다. 버전 헤더나 쿠키를 보고 블루/그린 중 한쪽으로 보내는 규칙도 여기에 겁니다. |
4. EKS: 서비스들이 실제로 돌아가는 곳
백엔드와 프론트 서버는 모두 컨테이너로 만들어 쿠버네티스 위에서 돌립니다. 서비스마다 언어와 프레임워크를 다르게 골라도 쿠버네티스 입장에서는 똑같은 컨테이너입니다.
용어 | 한 줄 정의 | 이 그림에서 하는 일 |
|---|---|---|
EKS / 쿠버네티스 | 컨테이너를 여러 서버에 배치하고 관리하는 플랫폼, EKS는 AWS의 관리형 버전 | "주문 서비스는 항상 3개"처럼 원하는 상태를 적어 두면, 죽은 컨테이너를 다시 띄우고 서버에 골고루 배치합니다. AWS에서는 더 단순한 ECS를 쓰기도 합니다. 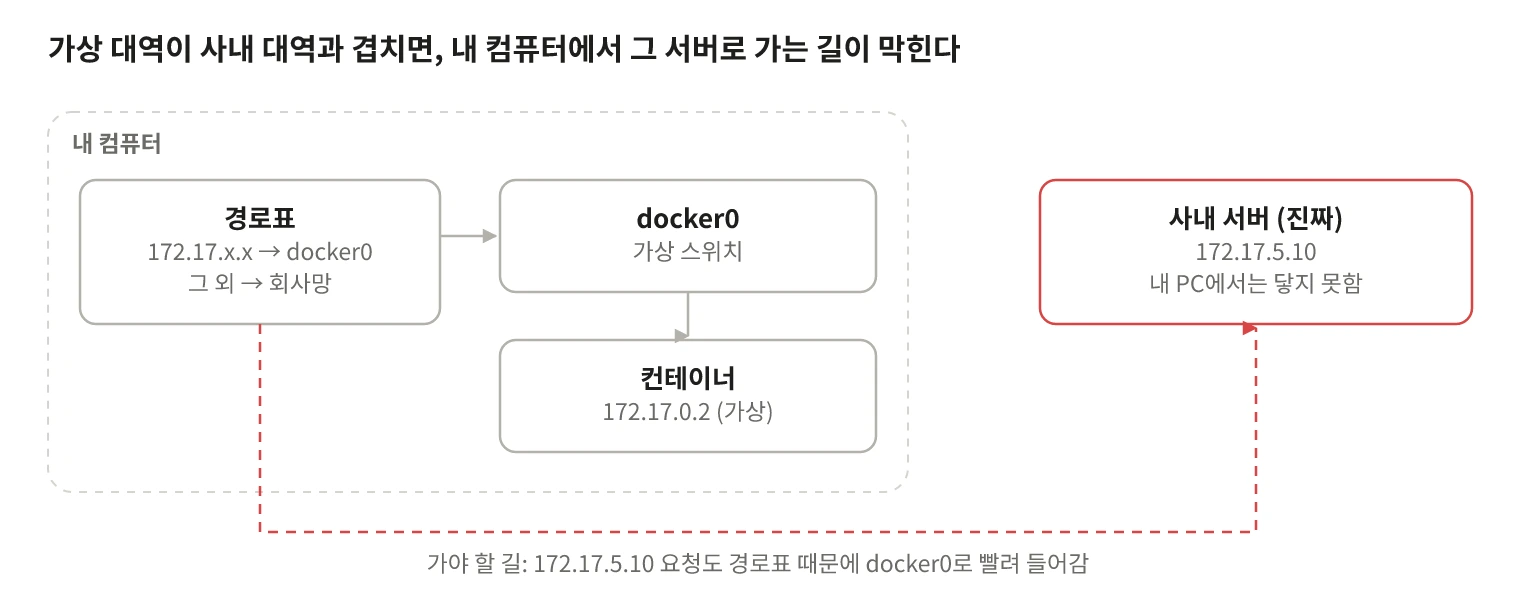 |
파드 | 쿠버네티스가 띄우는 가장 작은 실행 단위(컨테이너 묶음) | 그림의 작은 사각형입니다. 같은 서비스의 파드 여러 개가 요청을 나눠 받고, 하나가 죽어도 나머지가 버팁니다. |
Next.js | React 기반 프론트엔드 프레임워크 | 서버에서 페이지를 미리 그려 보내는 SSR을 담당합니다. 첫 화면이 빠르고 검색엔진에도 잘 잡힙니다. |
Auth 서버 | 로그인과 토큰 발급을 전담하는 서비스 | 비밀번호나 소셜 로그인을 확인하고 JWT 액세스 토큰과 리프레시 토큰을 발급합니다. 다른 서비스는 매번 Auth 서버에 묻지 않고 공개키로 토큰을 직접 검증합니다. |
JWT | 서명된 토큰(JSON Web Token) | "이 사람은 user 123"이라는 정보에 Auth 서버의 서명을 붙인 것입니다. 위조가 불가능해서 받는 쪽이 혼자 검증할 수 있습니다. |
주문 (Spring Boot) | 자바 웹 프레임워크로 만든 주문 서비스 | 트랜잭션이 복잡한 주문·결제 로직을 맡습니다. JPA(Hibernate)로 DB에 접근합니다. |
검색 API | 검색 요청을 처리하는 서비스 | Redis 캐시를 먼저 보고, 없으면 Elasticsearch에 키워드 검색과 벡터 검색을 함께 요청합니다(하이브리드 검색). |
실시간 (SSE · WebSocket) | 연결을 계속 유지하는 서비스 | 채팅·알림처럼 서버가 먼저 보내야 하는 메시지를 처리합니다. 파드끼리는 Redis Pub/Sub으로 메시지를 전달합니다. |
오토스케일 (HPA · Karpenter) | 부하에 따라 자동으로 늘리고 줄이는 장치 | HPA는 CPU나 요청 수를 보고 파드 개수를, Karpenter는 파드를 올릴 자리가 부족하면 서버(노드) 자체를 늘립니다. 노드 : CPU와 메모리 가진 실제 기계 (EC2 1대라고 생각) 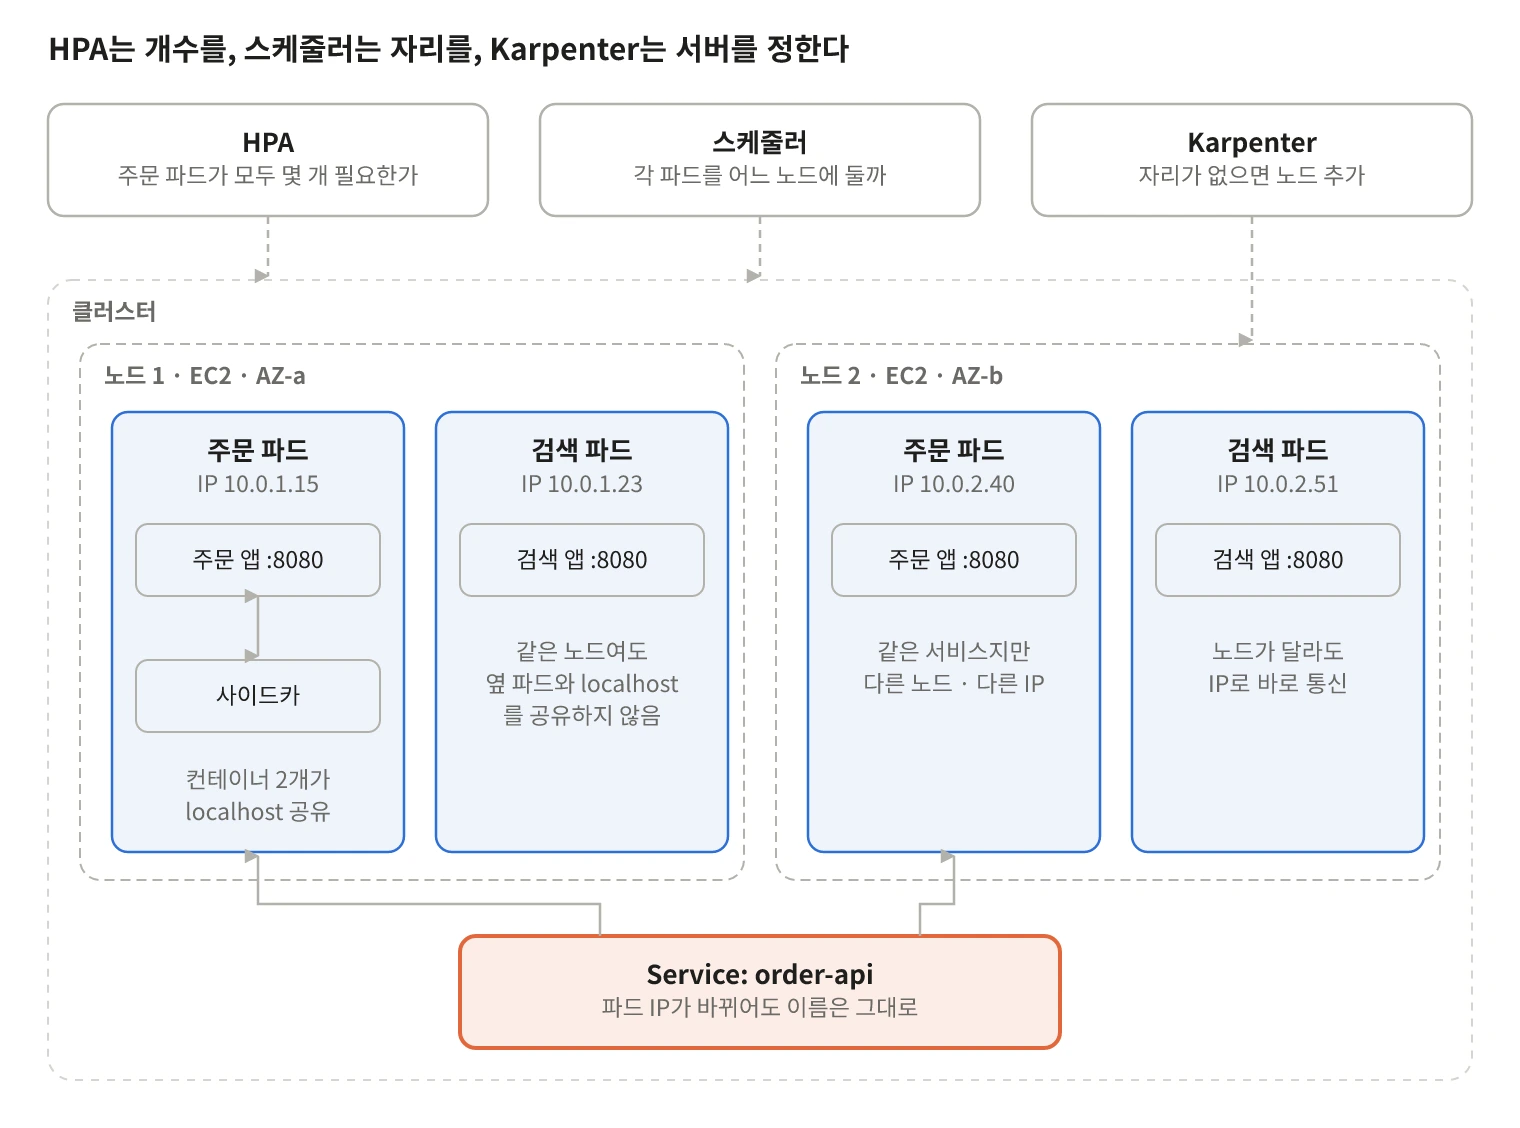 |
임베딩 API | 문장을 의미가 담긴 숫자 벡터로 바꿔 주는 외부 서비스 | 점선 박스는 클러스터 밖이라는 뜻입니다. 상품 설명과 사용자 질문을 같은 모델로 벡터화해 "뜻이 비슷한" 검색을 가능하게 합니다. |
5. DB · 캐시: 데이터의 원본과 빠른 사본
정확해야 하는 원본은 RDB에, 키 하나로 빠르게 꺼내야 하는 데이터는 캐시와 NoSQL에 둡니다.
용어 | 한 줄 정의 | 이 그림에서 하는 일 |
|---|---|---|
Redis | 메모리에 데이터를 두는 초고속 키-값 저장소 | 자주 조회하는 결과 캐시, 로그인 세션, 로그아웃된 토큰의 차단 목록, 실시간 서비스의 메시지 전달(Pub/Sub)까지 맡습니다. 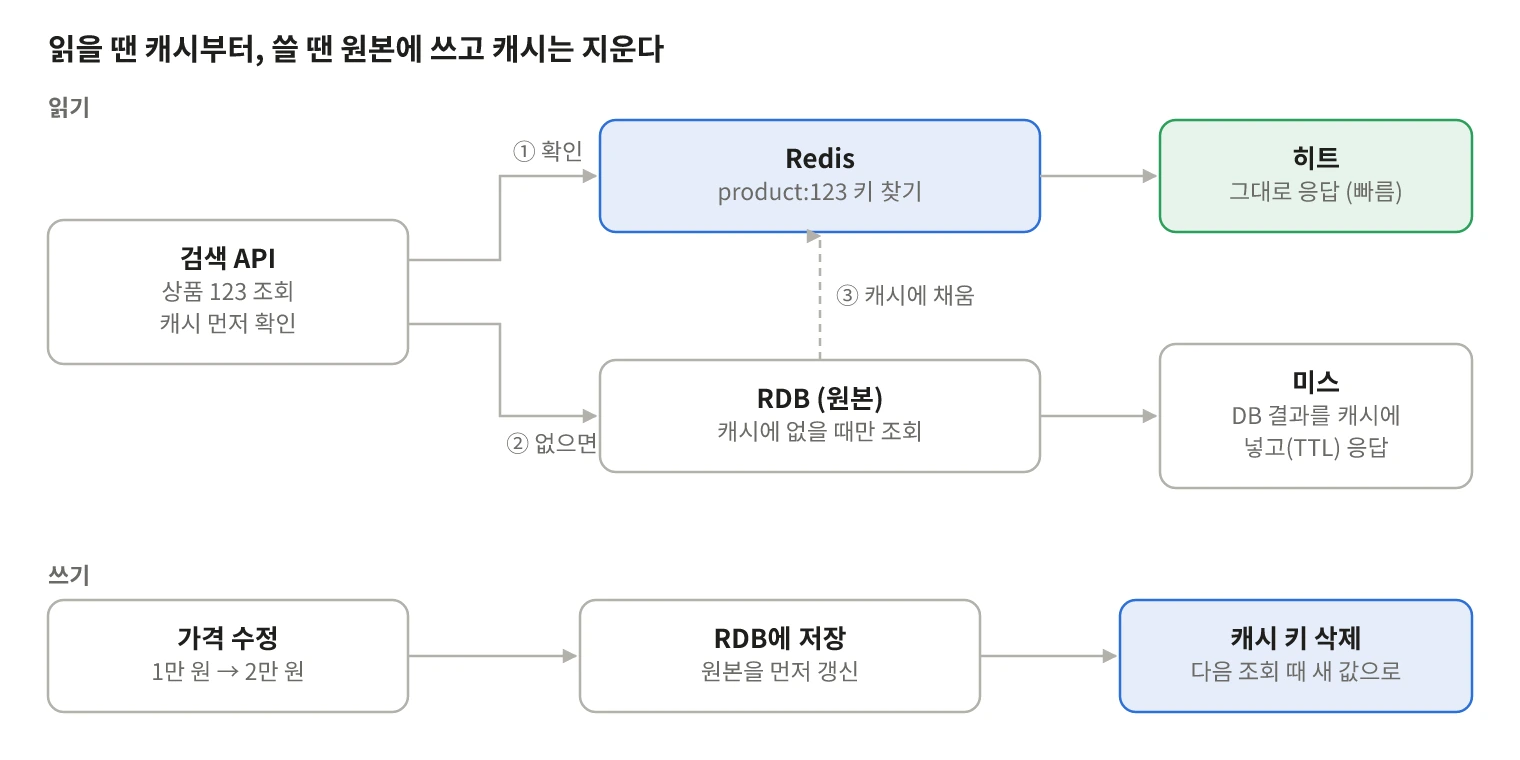 |
Auth DB | 계정 정보만 따로 둔 데이터베이스 | 가장 민감한 데이터라 다른 서비스 DB와 분리해 접근 권한을 좁게 관리합니다. |
Aurora | AWS의 관리형 관계형 DB(MySQL·PostgreSQL 호환) | 저장 공간이 3개 가용영역에 6벌로 복제되고, 장애 시 읽기 복제본이 30초 안팎에 쓰기 담당으로 승격됩니다. |
Multi-AZ | 여러 가용영역(데이터센터)에 나눠 배치하는 것 | 건물 하나가 정전돼도 다른 건물의 복제본이 이어받습니다. |
RDB | 테이블과 관계, 트랜잭션을 지원하는 관계형 데이터베이스 | 주문·결제·재고처럼 정확성이 필수인 데이터의 원본을 담습니다. |
샤드 라우터 (Vitess) | 쪼개진 DB 앞에서 쿼리를 알맞은 조각으로 보내는 장치 | user_id를 해시해서 그 사용자의 데이터가 있는 샤드로 쿼리를 보냅니다. 앱은 DB가 몇 조각인지 몰라도 됩니다. |
샤드 | 큰 DB를 키 기준으로 나눈 한 조각 | DB 한 대로 감당 못 할 쓰기를 여러 대에 나눕니다. 각 샤드는 쓰기를 받는 Primary와 복제본인 Replica로 이중화돼 있습니다. |
Primary · Replica | 쓰기 담당 원본 서버와, 그 복제본 서버 | Replica는 읽기를 나눠 받고, Primary가 죽으면 자동으로 승격됩니다. |
DynamoDB | AWS의 관리형 NoSQL 키-값·문서 DB | RDB에서 조인해야 나오는 "내 주문 목록" 같은 화면을 미리 한 덩어리로 만들어 두는 조회 모델입니다. 앱이 직접 쓰지 않고 Kafka에서 동기화됩니다. |
6. 스트리밍: 원본의 변경을 흘려보내는 파이프
여기부터는 사용자가 기다리지 않는 구간입니다. 원본 DB에서 일어난 변경을 빠짐없이, 순서대로 다른 시스템에 전달합니다.
용어 | 한 줄 정의 | 이 그림에서 하는 일 |
|---|---|---|
CDC | 변경 데이터 캡처(Change Data Capture) | DB에 커밋된 INSERT·UPDATE·DELETE를 DB의 변경 로그에서 그대로 읽어 냅니다. 앱이 두 군데에 동시에 쓰는 위험한 방식(듀얼 라이트)을 대신합니다. |
Debezium | 대표적인 오픈소스 CDC 도구 | MySQL의 binlog, PostgreSQL의 WAL을 읽어 "주문 123이 생성됨" 같은 이벤트로 바꿔 Kafka에 보냅니다. 샤드마다 하나씩 붙어 병렬로 읽습니다. |
Kafka | 대용량 이벤트를 순서대로 저장하고 전달하는 메시지 로그 | 이벤트를 토픽별로 며칠~몇 주 보관합니다. 동기화 컨슈머, 검색 색인, 분석이 각자 따로 구독하고, 죽었다 살아나도 멈춘 지점부터 다시 읽습니다. 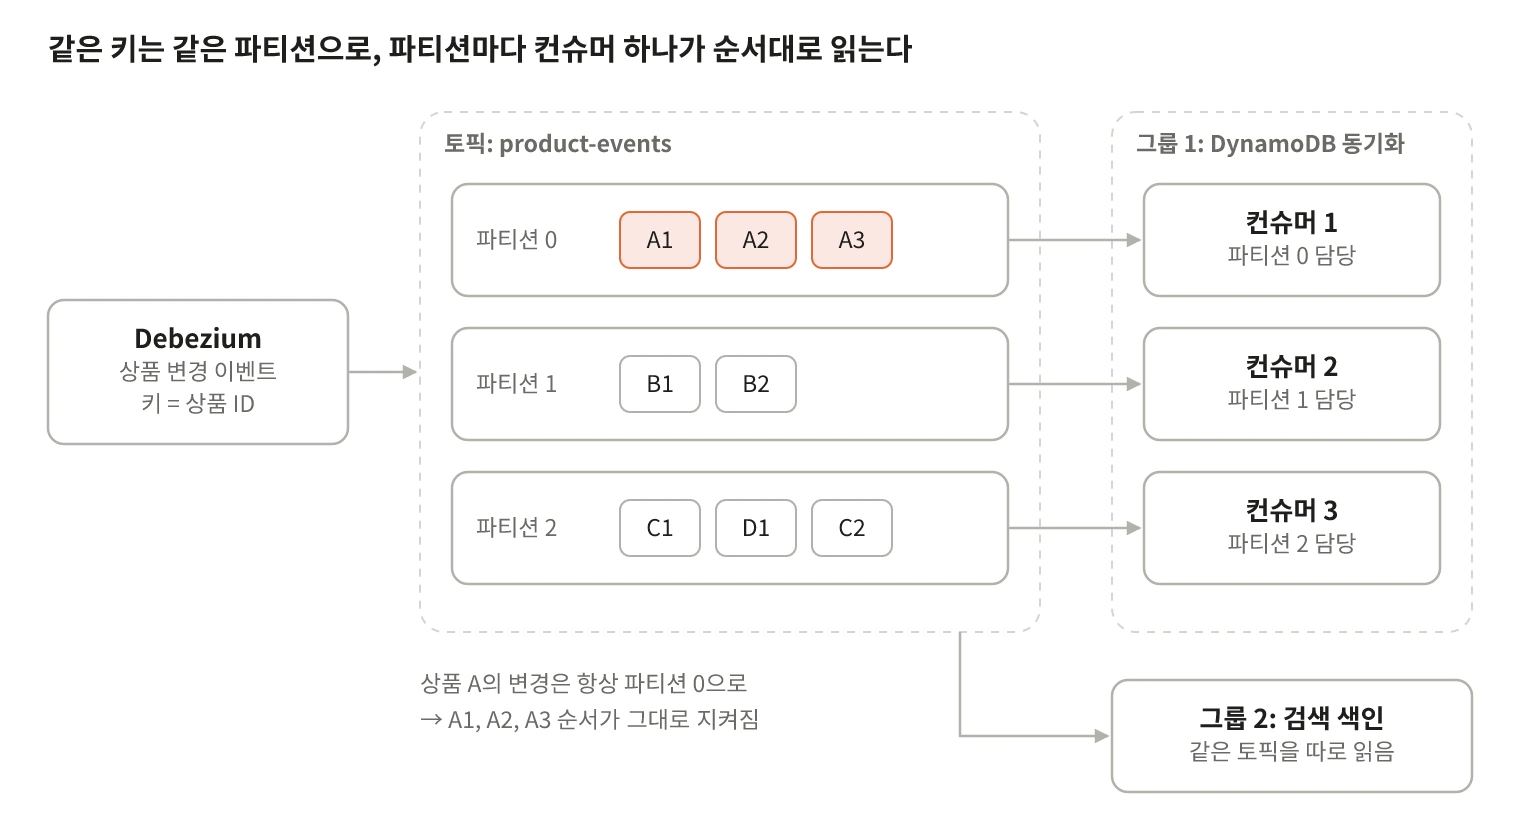 |
토픽 · 파티션 | Kafka에서 이벤트를 분류하는 단위와, 그 토픽을 병렬 처리하려고 나눈 칸 | 같은 상품의 이벤트는 같은 파티션에 들어가 순서가 지켜지고, 파티션 수만큼 컨슈머가 동시에 처리할 수 있습니다. |
컨슈머 | Kafka 토픽을 구독해 이벤트를 처리하는 서버 | 예를 들어 동기화 컨슈머는 주문 이벤트를 받아 조회용 모양으로 바꿔 DynamoDB에 씁니다. |
7. 처리: 데이터를 쓸모 있는 모양으로 바꾸기
흘러온 원본 이벤트를 검색·분석·ML이 바로 쓸 수 있는 모양으로 다듬습니다. 실시간으로 하나씩 처리하는 길과, 모아서 한꺼번에 처리하는 길이 있습니다.
용어 | 한 줄 정의 | 이 그림에서 하는 일 |
|---|---|---|
Flink | 끊임없이 들어오는 이벤트를 실시간으로 처리하는 스트리밍 엔진 | Kafka 이벤트를 받아 상품명·판매자명까지 합친 검색용 문서를 만들고(비정규화), 임베딩 API로 벡터를 붙여 Elasticsearch와 S3에 넣습니다. |
비정규화 | 여러 테이블에 나뉜 정보를 미리 합쳐 하나로 만드는 것 | 조회할 때 조인할 필요가 없어져 검색과 조회가 빨라집니다. |
Spark | 대량의 데이터를 여러 서버에서 나눠 계산하는 배치 처리 엔진 | 하루치 데이터를 S3에서 읽어 집계하고, 웨어하우스 테이블을 만듭니다. |
Airflow | 작업 순서와 일정을 관리하는 워크플로 스케줄러 | "매일 새벽 3시, 원본 정리 → 집계 → 대시보드 테이블 갱신" 같은 작업 순서를 정해 두고 실행하며, 실패하면 재시도하고 알립니다. |
배치 vs 스트리밍 | 모아서 한 번에 처리 vs 들어오는 즉시 처리 | 매출 리포트처럼 하루 단위면 배치, 검색 반영처럼 몇 초 안이어야 하면 스트리밍을 씁니다. 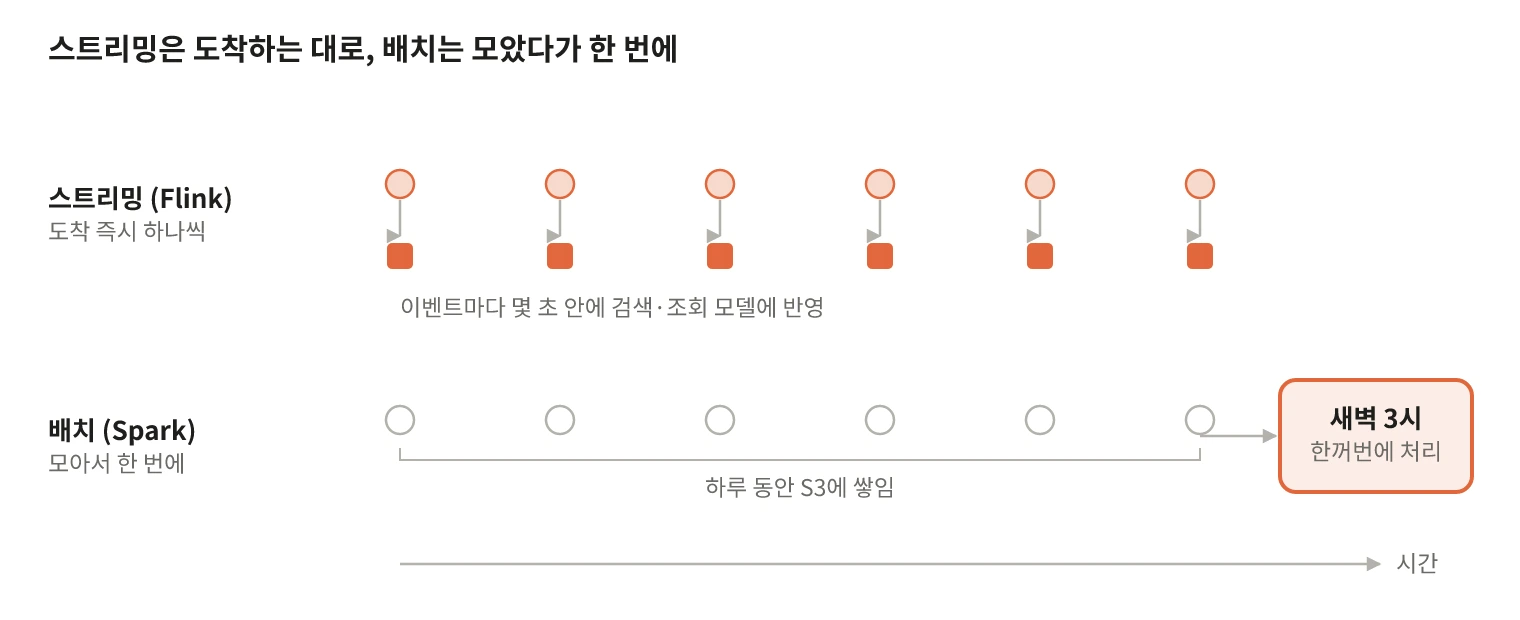 |
8. 저장: 용도별로 나뉜 사본 창고
처리된 데이터는 쓰임새에 맞는 저장소에 담깁니다. 모두 원본 DB에서 만든 사본이라, 망가지면 다시 만들 수 있습니다.
용어 | 한 줄 정의 | 이 그림에서 하는 일 |
|---|---|---|
웨어하우스 (Snowflake 등) | 분석용 SQL에 최적화된 데이터베이스 | "지난달 지역별 매출"처럼 수억 행을 훑는 집계 쿼리를 빠르게 처리합니다. BigQuery, Redshift도 같은 종류입니다. |
S3 데이터 레이크 | 모든 원본과 가공 데이터를 파일로 쌓아 두는 저렴한 저장소 | 원본(Bronze), 정리본(Silver), 집계본(Gold)을 층으로 나눠 보관합니다. DB 백업과 재처리의 출발점도 여기입니다. |
Parquet | 열(컬럼) 단위로 저장하는 파일 형식 | 분석 쿼리는 몇 개 컬럼만 읽는 경우가 많아, 필요한 열만 읽고 압축도 잘 됩니다. 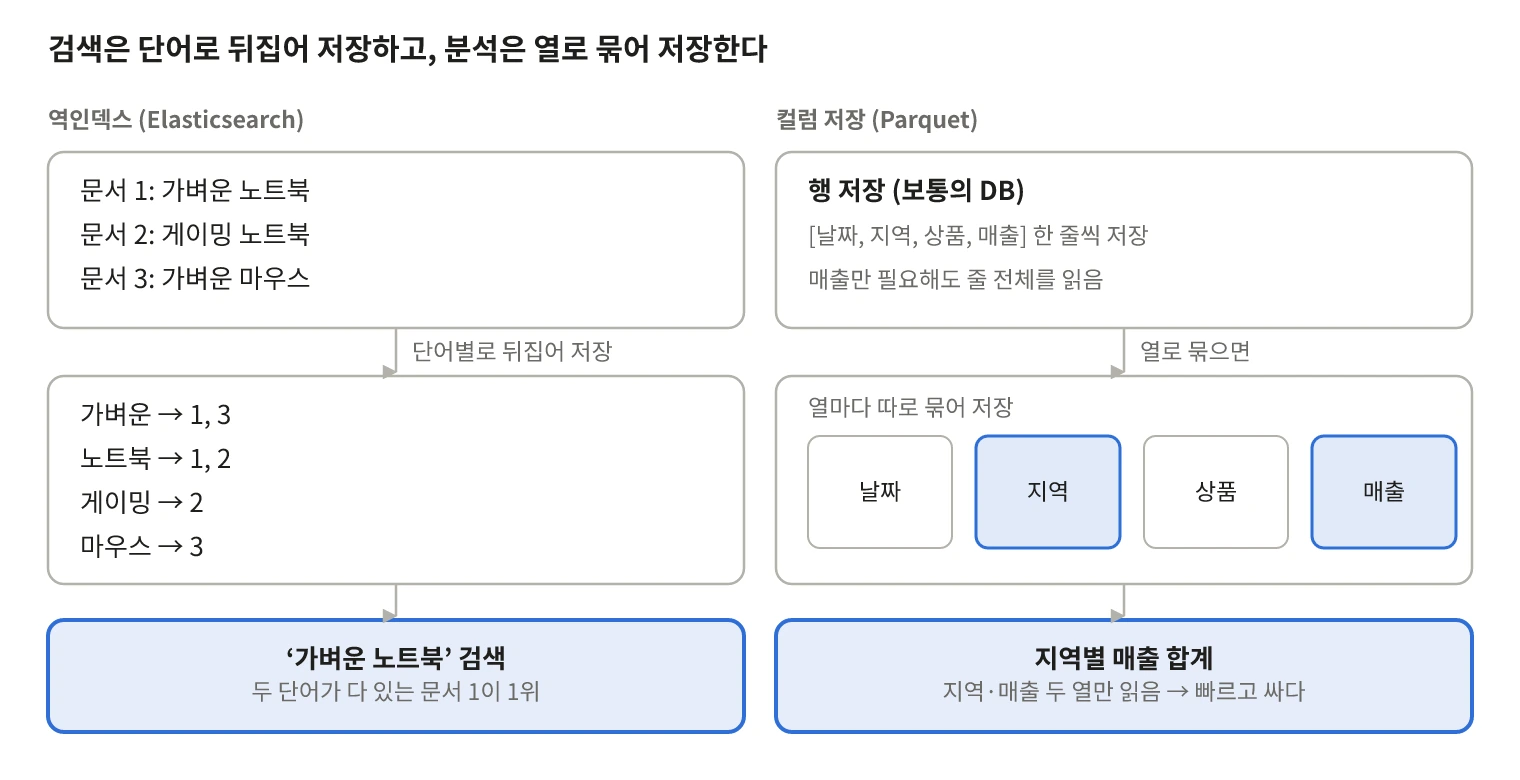 |
Iceberg | S3의 파일 묶음을 DB 테이블처럼 다루게 해 주는 테이블 포맷 | 수정·삭제, 스키마 변경, 과거 시점 조회를 지원하고, 파일 목록을 메타데이터로 관리해 테이블이 커져도 빠릅니다. 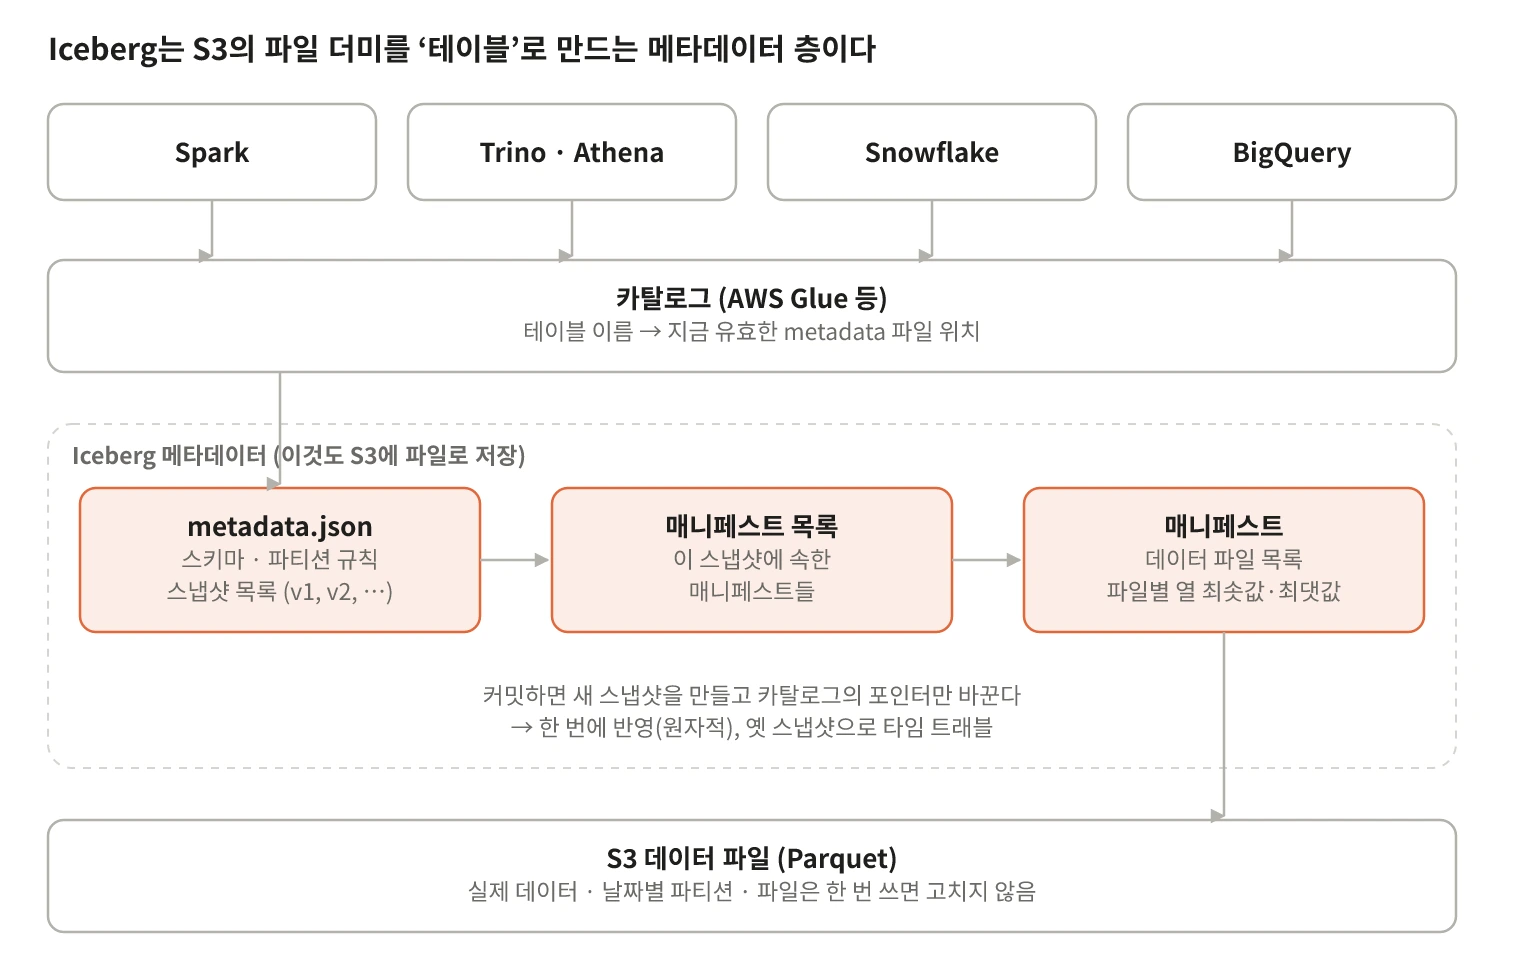 |
Elasticsearch | 검색 전용 엔진 | 단어마다 그 단어가 든 문서 목록을 거꾸로 저장(역인덱스)해서 전문 검색에 강합니다. 키워드 점수(BM25)와 벡터 유사도(k-NN)를 함께 써 하이브리드 검색을 합니다. |
9. 활용: 데이터가 가치로 바뀌는 곳
쌓인 데이터는 사람의 의사결정과 서비스 개선으로 돌아옵니다.
용어 | 한 줄 정의 | 이 그림에서 하는 일 |
|---|---|---|
BI 대시보드 | 비즈니스 지표를 차트로 보여 주는 도구(Tableau, Superset, Looker 등) | 웨어하우스의 집계 테이블을 읽어 매출, 전환율, 재구매율 같은 지표를 팀이 매일 보게 합니다. |
ML · 추천 모델 | 데이터에서 패턴을 학습해 예측하는 모델 | S3 레이크의 구매·클릭 기록으로 "이 상품을 본 사람이 산 상품" 같은 추천 모델을 학습하고, 결과를 다시 서비스에 반영합니다. |
10. 관측: 운영 중인 시스템을 들여다보는 눈
모든 층에서 나오는 로그와 지표를 모아, 문제가 생기면 빨리 알아채고 원인을 찾게 합니다. 그림 왼쪽의 점선이 모든 파드에서 관측 데이터를 모으는 길입니다.
용어 | 한 줄 정의 | 이 그림에서 하는 일 |
|---|---|---|
로그 · 메트릭 · 트레이스 | 관측의 세 가지 신호 | 메트릭은 "뭔가 이상하다", 트레이스는 "어느 구간에서", 로그는 "정확히 무슨 일이"를 알려 줍니다. 셋을 같은 trace_id로 엮어 둡니다. |
Fluent Bit | 가벼운 로그 수집기 | 쿠버네티스 노드마다 하나씩 떠서, 파드가 표준 출력에 찍은 로그를 모아 저장소로 보냅니다. |
OpenTelemetry (OTel) | 메트릭과 트레이스를 표준 방식으로 만들고 보내는 도구 모음 | 앱 코드의 SDK가 요청 하나가 ALB부터 DB까지 각 구간에서 쓴 시간을 기록하고, Collector가 이를 모아 보냅니다. |
OpenSearch | Elasticsearch에서 갈라져 나온 검색 엔진 | 여기서는 로그 저장·검색용으로 씁니다. Grafana Loki를 대신 쓰기도 합니다. |
Prometheus | 시계열 지표 수집·저장 도구 | 각 파드의 요청 수, 응답 시간, 에러율을 주기적으로 긁어 모으고 알림 규칙을 평가합니다. |
Tempo | 트레이스 저장소 | 느린 요청 하나를 열어 어느 구간에서 시간이 걸렸는지 보여 줍니다. Jaeger도 같은 역할입니다. 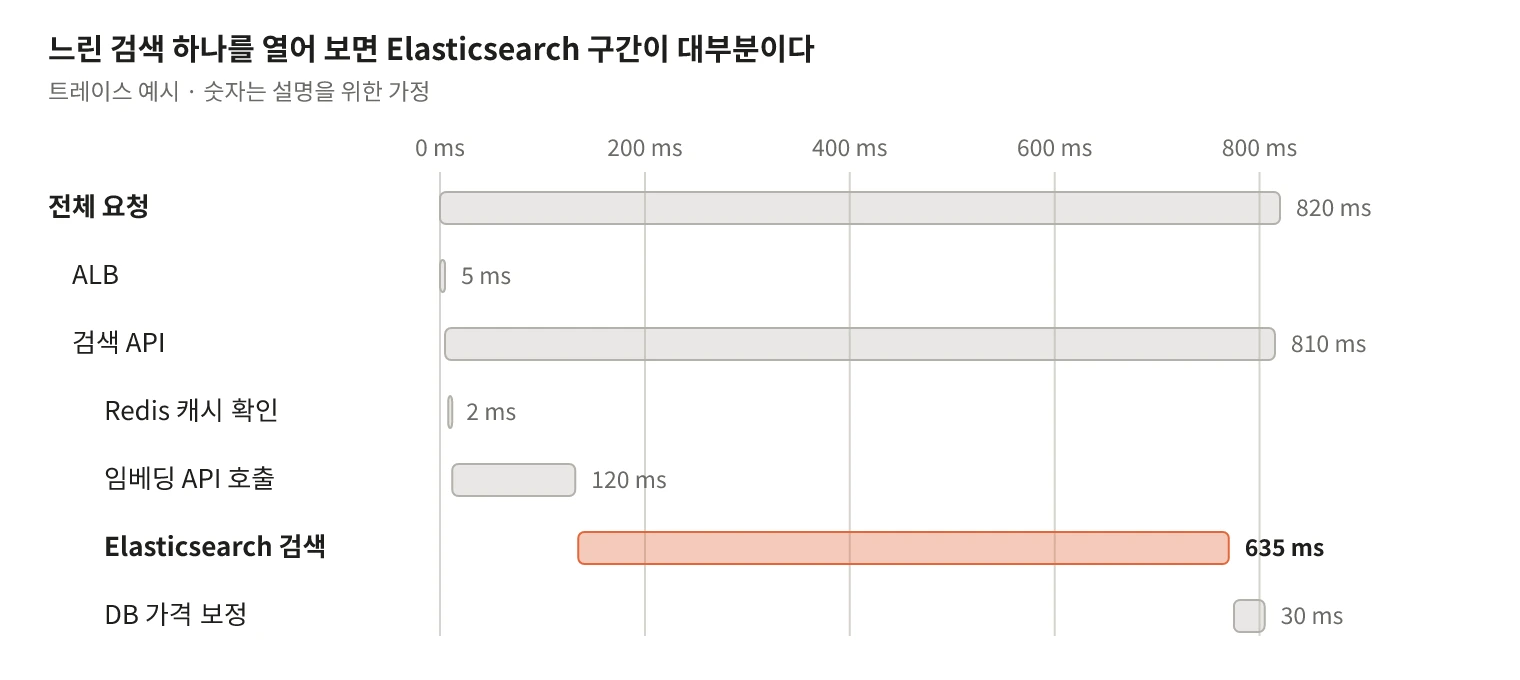 |
Grafana | 관측 데이터를 한 화면에 모아 보는 대시보드 | 지표 그래프에서 튀는 지점을 눌러 그 시각의 트레이스와 로그로 바로 이동합니다. 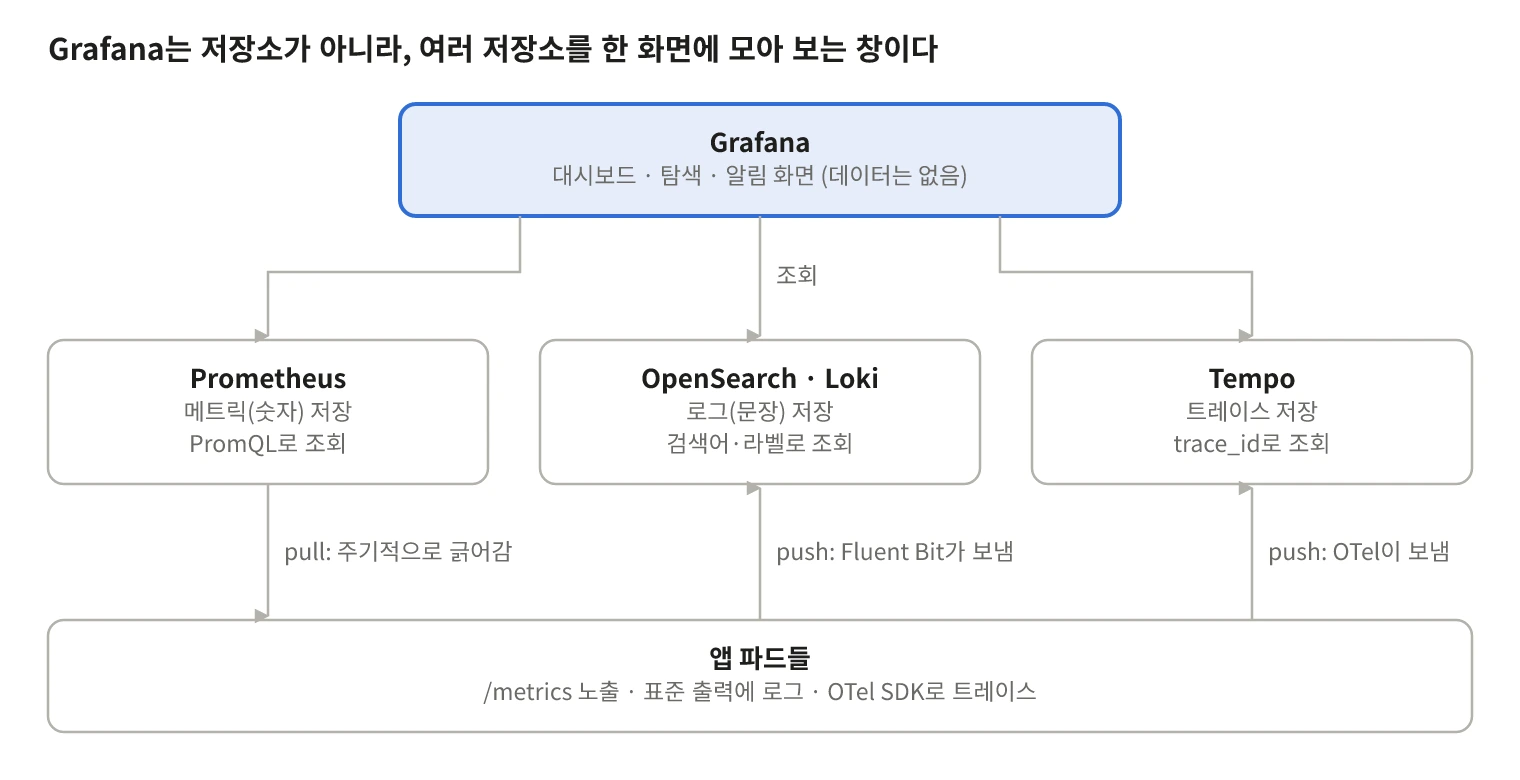 |
알림 (Slack · PagerDuty) | 문제를 사람에게 전달하는 경로 | "주문 API 99%가 300ms 안에 성공" 같은 목표(SLO)가 깨질 때만 온콜 담당자를 깨웁니다. 알림이 너무 잦으면 결국 무시되기 때문입니다. |
마치며
한 번에 되게 많은 양의 용어들을 설명했어요. 아마 처음 들어보면 한번에 공부하긴 힘들거 같아요. 그래도 해내야만 해요... 그리고 필요에 따라 적절하게 사용해야합니다. 시대가 그렇게 된거 같아요.
이 글은 [직접 쓰기 + AI 활용] 글입니다.